2 Données QDA — Caractérisation de l’espace sensoriel
2.1 Introduction
Cette analyse est conçue pour les données de type QDA (Quantitative Descriptive Analysis), lorsque plusieurs sujets évaluent plusieurs stimuli à l’aide d’une liste fixe d’attributs sensoriels. Elle répond à deux questions complémentaires : quels attributs structurent l’espace sensoriel dans son ensemble et quels attributs caractérisent chaque stimulus en particulier. La fonction renvoie précisément deux familles de résultats : une liste triée des attributs qui différencient l’ensemble des stimuli, puis, pour chaque stimulus, une liste des attributs qui le caractérisent.
Pourquoi ne pas utiliser une alternative standard ?
Une simple comparaison de moyennes par stimulus peut être trompeuse si les sujets n’utilisent pas tous l’échelle de notation de la même façon. Ici, l’analyse tient compte à la fois de l’effet produit (Stimulus Effect) et de l’effet sujet (Subject Effect), ce qui permet d’identifier des attributs discriminants et des profils de manière plus robuste qu’une lecture purement descriptive.
Pour tester cette fonction, il vous suffit de charger les données sensochoc disponibles avec le module SEDA — elles apparaissent dans la liste des jeux de données d’exemple lors de l’ouverture d’un nouveau fichier dans jamovi.
2.2 Comprendre ce qui se passe “sous le capot”
2.2.1 Vérification et préparation des données
L’analyse commence par vérifier que la variable placée dans le champ Stimulus Effect (effet produit) et celle placée dans le champ Subject Effect (effet sujet) peuvent être traitées comme des facteurs, et que toutes les variables placées dans Sensory Attributes sont numériques. Si un attribut sensoriel n’est pas numérique, l’analyse s’arrête avec un message d’erreur.
2.2.2 Une analyse attribut par attribut
Une manière simple de comprendre le calcul est de dire que la fonction procède attribut par attribut par une analyse de variance (ANOVA). Pour chaque variable de Sensory Attributes, elle évalue d’abord si l’effet produit est significatif, tout en tenant compte de l’effet sujet. Cette première étape joue le rôle de filtre global : elle détermine quels attributs structurent réellement l’espace sensoriel.
2.2.3 Sélection des attributs discriminants
Les attributs dont la significativité est inférieure au seuil défini par Significance threshold (%) sont retenus dans la première table de résultats. Le seuil par défaut est de 5 %, ce qui en fait un bon point de départ pour une lecture prudente. Si aucun attribut ne passe ce seuil, la fonction s’arrête et indique qu’aucun attribut sensoriel n’est discriminant au seuil sélectionné.
2.2.4 Description stimulus par stimulus
Une fois les attributs globalement discriminants repérés, la fonction examine, pour chaque stimulus, quels attributs le caractérisent significativement. Chaque stimulus est comparé à une référence globale, ce qui permet de repérer des attributs associés positivement ou négativement à ce stimulus. La référence globale correspond à la moyenne des stimuli sur chaque attribut (le stimulus moyen). Le résultat prend la forme d’une seconde table regroupée par stimulus.
2.2.5 Le rôle des moyennes ajustées
La colonne Adjusted mean peut se comprendre comme une estimation de la moyenne du stimulus sur un attribut, corrigée de l’effet sujet. Cette colonne permet de lire le niveau de perception d’un stimulus sans se limiter à une moyenne brute potentiellement influencée par des sujets plus “généreux” ou plus “sévères” dans leur notation.
Lorsque le plan de dégustation est complet (chaque sujet évalue tous les stimuli), la moyenne ajustée est égale à la moyenne arithmétique. Elle s’en écarte en présence de données manquantes ; la moyenne ajustée est alors plus fiable.
2.2.6 Ce que signifie un stimulus absent de la seconde table, Sensory Description of the Stimuli
Un stimulus peut ne pas apparaître dans la seconde table si aucun attribut ne le caractérise significativement au seuil choisi. Cela ne signifie pas qu’il est “sans profil”, mais plutôt qu’il ne se distingue pas assez nettement de la moyenne de l’ensemble des stimuli sur les attributs testés.
2.3 Structure des données attendues
Les données doivent contenir :
- une colonne identifiant les stimuli ;
- une colonne identifiant les sujets ;
- plusieurs colonnes numériques correspondant aux attributs sensoriels.
Chaque ligne correspond à l’évaluation d’un stimulus par un sujet. Si les sujets évaluent les stimuli en plusieurs répétitions ou en plusieurs sessions, chaque évaluation doit apparaître sur une ligne distincte.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- la variable destinée à Stimulus Effect est bien catégorielle ;
- la variable destinée à Subject Effect est bien catégorielle ;
- toutes les variables destinées à Sensory Attributes sont numériques.
2.4 Guide de l’interface
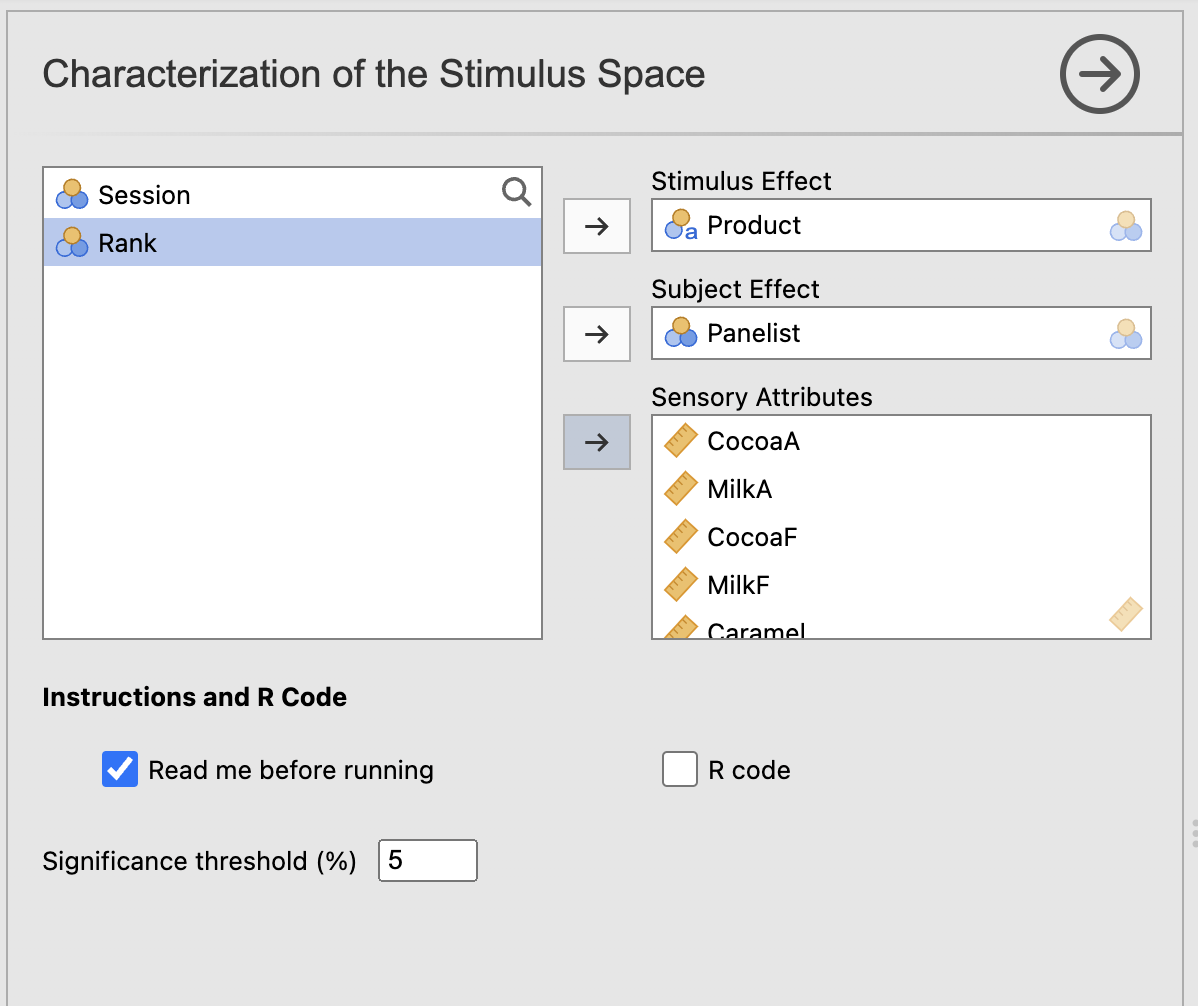
L’analyse apparaît dans le menu SEDA > Fixed List of Attributes > Characterization of the Stimulus Space. L’interface comprend trois zones de dépôt de variables, un bloc Instructions and R Code contenant les cases Read me before running et R code, puis un champ numérique Significance threshold (%).
2.4.1 Variables à renseigner
2.4.1.1 Stimulus Effect
Rôle : identifie les stimuli/produits à comparer. Impact sur le calcul : cette variable définit les groupes étudiés dans l’analyse globale et dans la description stimulus par stimulus. Conseil pratique : utilisez des libellés explicites, car ils structurent directement la lecture de la seconde table.
2.4.1.2 Subject Effect
Rôle : identifie les sujets. Impact sur le calcul : cette variable est utilisée pour tenir compte des différences systématiques entre sujets lors de l’estimation des effets stimulus. Conseil pratique : vérifiez qu’un même sujet conserve exactement le même identifiant dans tout le fichier.
2.4.1.3 Sensory Attributes
Rôle : regroupe les attributs sensoriels analysés. Impact sur le calcul : la fonction applique la même logique d’analyse à chacun de ces attributs ; seuls les attributs numériques sont acceptés. Conseil pratique : incluez tous les attributs pertinents de votre QDA ; la sélection statistique se fera ensuite via Significance threshold (%).
2.4.2 Instructions and R Code
2.4.2.1 Read me before running
Rôle : affiche une aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez-la cochée lors des premières utilisations. Elle est activée par défaut.
2.4.2.2 R code
Rôle : affiche le script R correspondant à l’analyse dans une sortie R Code. Impact sur le calcul : aucun. Conseil pratique : activez cette option si vous souhaitez reproduire l’analyse dans le Rj Editor de jamovi ou poursuivre ensuite le travail dans R. Elle est désactivée par défaut.
2.4.3 Seuil de significativité : Significance threshold (%)
Rôle : fixe le seuil de la p-value utilisé pour sélectionner les attributs discriminants et les attributs caractéristiques de chaque stimulus. Impact sur le calcul : ce seuil contrôle à la fois quels attributs apparaissent dans Identification of the Sensory Dimensions (test global) et quels attributs apparaissent dans Sensory Description of the Stimuli (tests par stimulus). Un seuil faible produit des résultats plus conservateurs ; un seuil plus élevé retient davantage d’attributs dans les deux tables. Conseil pratique : la valeur par défaut est 5 %, bon point de départ pour un premier essai. Si les résultats sont trop pauvres, essayez 10 %, puis éventuellement 20 % en exploration.
2.5 Procédure pas à pas
- Ouvrez votre jeu de données dans jamovi.
- Dans l’onglet Données, vérifiez que la variable stimulus est catégorielle, que la variable sujet est catégorielle, et que les attributs sensoriels sont numériques.
- Ouvrez SEDA > Fixed List of Attributes > Characterization of the Stimulus Space.
- Placez la variable stimulus dans Stimulus Effect.
- Placez la variable sujet dans Subject Effect.
- Placez tous les attributs sensoriels dans Sensory Attributes.
- Laissez Significance threshold (%) à 5 % pour un premier essai.
- Lisez d’abord Identification of the Sensory Dimensions pour repérer les attributs qui structurent l’espace sensoriel.
- Lisez ensuite Sensory Description of the Stimuli pour comprendre les caractéristiques propres à chaque stimulus.
- Si aucun résultat n’apparaît, ou si la seconde table est très pauvre, testez un seuil un peu plus large.
2.6 Interprétation des résultats
2.6.1 Identification of the Sensory Dimensions
Ce premier tableau liste les attributs sensoriels qui discriminent significativement les stimuli, triés du plus discriminant au moins discriminant. Il constitue la porte d’entrée de l’interprétation : il indique quels attributs structurent l’espace sensoriel dans son ensemble.
| Élément | Signification |
|---|---|
| (première colonne) | Attribut sensoriel discriminant |
| Vtest | Mesure standardisée de l’effet discriminant — plus la valeur est élevée, plus le signal est marqué |
| p | P-value du test global — plus elle est faible, plus l’attribut différencie nettement les stimuli |
Les premières lignes du tableau correspondent aux attributs les plus structurants.
Point de vigilance : un attribut absent de ce tableau n’est pas suffisamment discriminant au seuil choisi. Si aucun attribut n’est retenu, la fonction affiche un message d’erreur et ne produit pas de résultat interprétable.
2.6.2 Sensory Description of the Stimuli
Ce second tableau décrit chaque stimulus par les attributs qui le caractérisent significativement. Les lignes sont regroupées par stimulus, et les attributs les plus saillants apparaissent en premier au sein de chaque groupe.
| Élément | Signification |
|---|---|
| (première colonne) | Nom du stimulus |
| Descriptor | Attribut sensoriel caractéristique |
| Coefficient | Écart estimé par rapport à la référence globale — positif si le stimulus est perçu plus intensément, négatif sinon |
| Adjusted mean | Moyenne ajustée du stimulus sur cet attribut, corrigée de l’effet sujet |
| p | P-value du test de caractérisation |
| Vtest | Intensité standardisée de l’association — positive = sur-représenté, négative = sous-représenté |
- Une V-test positive suggère que le stimulus est perçu comme plus intense que la référence (la moyenne) sur cet attribut.
- Une V-test négative suggère l’inverse — et est tout aussi informative.
- Appuyez-vous sur Adjusted mean pour lire le niveau sensoriel, mais ne l’interprétez jamais sans p et Vtest.
Point de vigilance : un stimulus absent du tableau n’est pas “sans profil” ; il est simplement non significativement différent de la moyenne de l’ensemble des stimuli au seuil choisi.
Dans la configuration actuelle de la fonction, aucune sortie graphique n’est produite. L’interprétation repose entièrement sur les deux tables de résultats.
2.7 Exemple : le jeu de données sensochoc
Le jeu de données sensochoc décrit 6 chocolats évalués par 29 sujets sur 14 attributs sensoriels. Il sert à illustrer les sorties de la fonction. Les valeurs numériques commentées ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
2.7.1 Paramètres de l’exemple
Pour reproduire cet exemple, voici les valeurs à utiliser.
| Option | Valeur |
|---|---|
| Stimulus Effect | Product |
| Subject Effect | Panelist |
| Sensory Attributes | tous les attributs sensoriels numériques |
| Significance threshold (%) | 5 |
Figure 2.1 présente la configuration utilisée pour l’exemple sensochoc.
2.7.2 Analyse du tableau Identification of the Sensory Dimensions
Avec ces réglages, les 14 attributs ressortent tous comme discriminants au seuil de 5 %. Le tableau est trié par V-test décroissante : les attributs en tête sont ceux qui différencient le plus nettement les chocolats entre eux. MilkF arrive en premier (V-test = 16.40), suivi de CocoaF (13.48) et Bitterness (13.34). En bas du tableau, Sticky (V-test = 3.56) et Granular (4.37) sont significatifs mais moins structurants. Ce classement donne une première lecture de l’espace sensoriel : les oppositions entre chocolats reposent avant tout sur les dimensions lactée, cacaotée et amère.
2.7.3 Analyse du tableau Sensory Description of the Stimuli
Figure 2.2 illustre la table de description des stimuli.
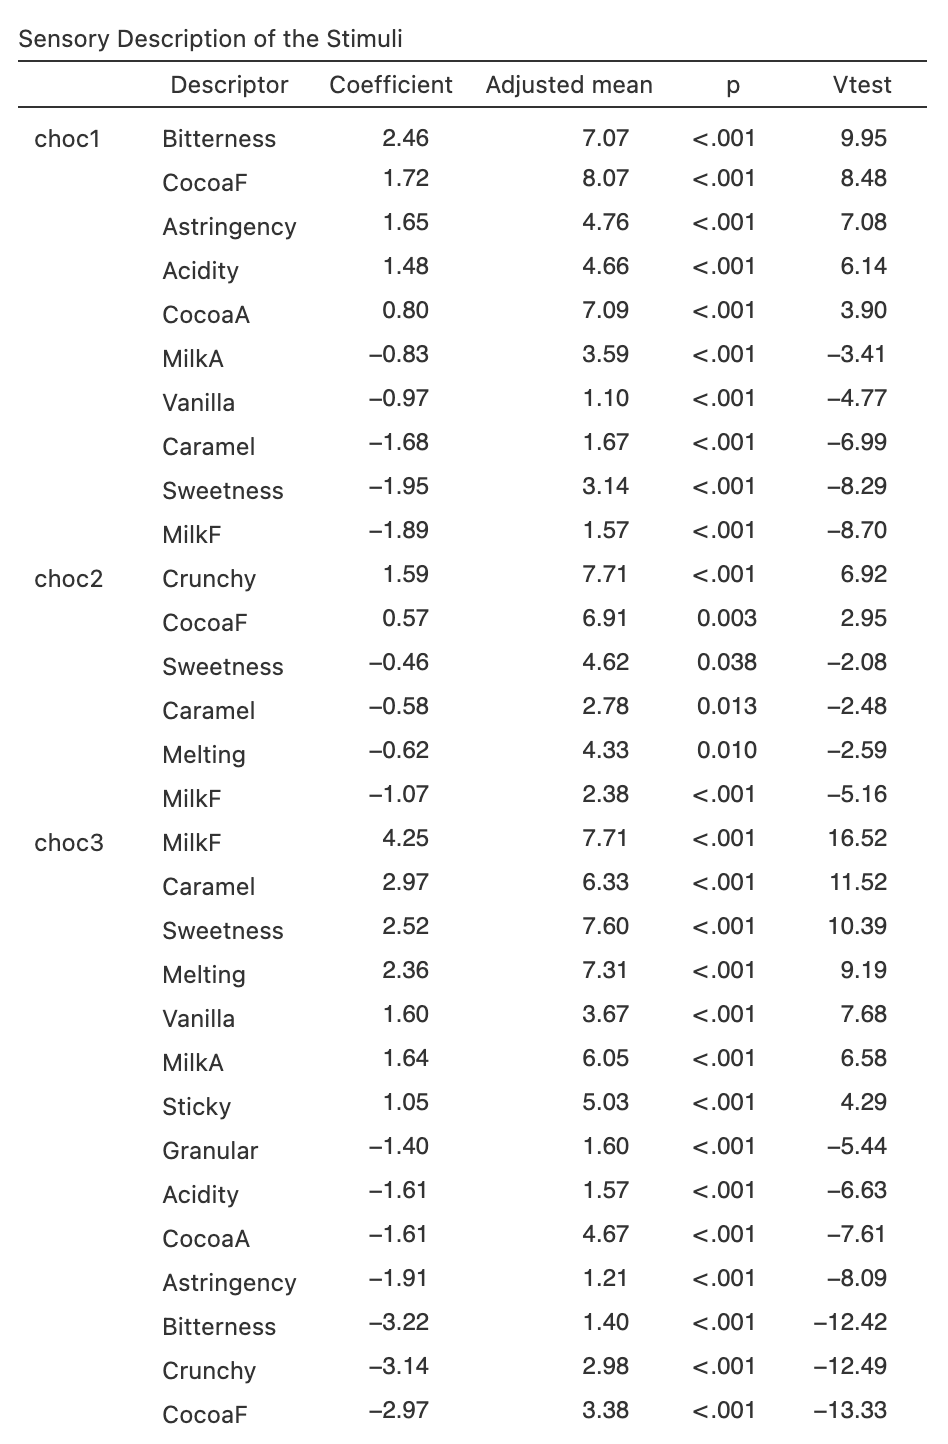
La seconde table permet de lire le profil de chaque chocolat par rapport à la moyenne générale de l’ensemble des six chocolats.
choc1 est caractérisé par un profil très contrasté. Pour ce chocolat, côté positif, Bitterness ressort avec la V-test la plus élevée (9.95, coefficient +2.46) et une moyenne ajustée de 7.07, nettement au-dessus de la moyenne de l’ensemble. CocoaF (V-test = 8.48), Astringency (7.08) et Acidity (6.14) complètent ce profil. Côté négatif, Sweetness (V-test = -8.29, coefficient -1.95, moyenne ajustée 3.14) et MilkF (V-test = -8.70) désignent un chocolat très peu sucré et très peu lacté.
choc3 présente le profil opposé. Il est fortement caractérisé par MilkF (V-test = 16.52, la plus élevée du tableau), Caramel (11.52), Sweetness (10.39) et Melting (9.19). À l’inverse, il est négativement caractérisé par Bitterness (-12.42), Crunchy (-12.49) et CocoaF (-13.33). C’est le chocolat le plus lacté, sucré et fondant, et le moins amer et cacaoté. Au vu du nombre d’attributs sensoriels significatifs, choc3 semble être le chocolat dont le profil va s’écarter le plus nettement de la moyenne.
choc2 se distingue surtout par Crunchy (V-test = 6.92) et une moindre perception de MilkF (-5.16). choc6 est également Crunchy (5.35) et légèrement plus Sweetness (2.41), mais moins Melting (-3.08).
choc4 affiche un profil modéré et peu contrasté — à l’exception de MilkF, aucune V-test ne dépasse 4 en valeur absolue — ce qui suggère un chocolat proche de la moyenne sensorielle générale sur la plupart des attributs.
choc5 présente très peu de caractéristiques saillantes : seuls CocoaA, Crunchy et CocoaF ressortent légèrement en positif, et Sticky en négatif. Son profil est le moins distinctif des six chocolats au seuil de 5 %.
2.7.4 Interprétation synthétique
Cet exemple montre que les six chocolats couvrent un espace sensoriel large, avec à un extrême un chocolat très amer et intense (choc1) et, à l’autre, un chocolat lacté, sucré et fondant (choc3). Entre ces deux pôles, les autres chocolats occupent des positions plus intermédiaires. La première table permet d’identifier les attributs qui structurent globalement l’espace sensoriel, tandis que la seconde précise le profil propre à chaque stimulus. La lecture conjointe de ces deux sorties constitue l’apport principal de la fonction.
Ce qu’on retient de cet exemple : l’analyse combine une lecture globale des attributs discriminants et une lecture locale des profils de stimuli, ce qui permet de caractériser finement l’espace sensoriel.
2.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code pour afficher le script correspondant à l’analyse. Le jeu de données actuellement ouvert dans jamovi est disponible sous le nom data.
Pour cette analyse, le script charge SensoMineR, prépare les variables sélectionnées puis appelle decat() avec un modèle comprenant l’effet stimulus et l’effet sujet. La valeur de Significance threshold (%) est transmise à l’argument proba : 5 % dans l’interface correspond à 0.05 en R. Les objets res_QDA$resF et res_QDA$resT correspondent respectivement aux deux tables commentées dans ce chapitre.
Cette sortie permet de vérifier et de reproduire le calcul, puis de poursuivre l’analyse dans R si nécessaire. Elle n’est pas indispensable pour utiliser SEDA.
2.9 Conseils pratiques
- Commencez avec Significance threshold (%) = 5 %.
- Si aucun attribut n’est retenu, testez 10 %, puis 20 % en exploration.
- Lisez toujours la table globale avant la table stimulus par stimulus.
- Ne confondez pas un attribut globalement discriminant avec un attribut qui caractérise fortement tous les stimuli : un attribut peut différencier les stimuli entre eux sans que tous soient fortement associés à lui.
- Une V-test négative est informative : elle signale qu’un stimulus est perçu comme moins intense que la moyenne sur un attribut, ce qui peut être une caractéristique sensorielle à part entière.
- Utilisez des noms de stimuli clairs et cohérents pour faciliter la lecture des résultats.
- Si votre panel comporte des répétitions, conservez toutes les lignes dans le fichier.
- Ne surinterpretez pas l’absence d’un stimulus dans la seconde table : il peut simplement se situer proche de la moyenne sensorielle générale.
2.10 En résumé
Cette analyse identifie d’abord les attributs sensoriels qui discriminent globalement les stimuli, puis décrit chaque stimulus par les attributs qui le distinguent de la référence globale (la moyenne). Elle tient compte à la fois de l’effet stimulus et de l’effet sujet, ce qui la rend plus informative qu’une simple comparaison de moyennes brutes. Son intérêt principal est de combiner une lecture globale de l’espace sensoriel et une lecture locale stimulus par stimulus, dans deux tables directement interprétables.