5 Données JAR — Analyse des défauts et pénalités
5.1 Introduction
Cette analyse est conçue pour les données JAR (Just About Right), dans lesquelles les sujets évaluent un attribut sensoriel par rapport à un niveau jugé idéal : par exemple pas assez / juste comme il faut / trop. Elle permet d’identifier les écarts au niveau JAR, d’estimer leur fréquence et d’étudier leur lien avec l’appréciation.
SEDA fournit deux lectures complémentaires des pénalités. La première est une lecture globale, issue de SensoMineR::JAR, qui estime l’importance des défauts dans l’ensemble de l’espace produit. La seconde est une analyse classique spécifique à chaque produit, qui compare, pour un produit donné, le liking des consommateurs situés au niveau JAR à celui des consommateurs situés en dessous ou au-dessus du JAR. L’ensemble associe ainsi une lecture multidimensionnelle des défauts et la penalty analysis classique spécifique à chaque produit.
Pourquoi ne pas utiliser une simple moyenne de liking ?
Une moyenne d’appréciation par produit ne dit pas quels écarts sensoriels sont associés à une baisse de liking. De même, la seule fréquence des réponses JAR ne permet pas de savoir si un défaut fréquent est réellement pénalisant. L’intérêt de l’analyse est donc de croiser trois informations différentes : la fréquence du défaut, la taille de la perte de liking et l’incertitude statistique autour de cette perte.
5.2 Comprendre ce qui se passe “sous le capot”
5.2.1 Vérification et regroupement du codage JAR
La valeur saisie dans Coding of the JAR level doit correspondre exactement à la modalité qui représente le niveau idéal dans chaque attribut JAR. La valeur par défaut est jar.
Pour l’analyse classique spécifique à chaque produit, SEDA regroupe ensuite les autres modalités en deux directions :
- Below JAR : niveau inférieur au niveau idéal ;
- Above JAR : niveau supérieur au niveau idéal.
Ce regroupement repose sur les expressions définies dans Below-JAR keywords et Above-JAR keywords. La première sortie à consulter est donc JAR Coding Used for the Classical Penalty Analysis. Une modalité indiquée comme Unclassified doit être corrigée avant d’interpréter l’analyse classique ; l’attribut concerné est sinon exclu de cette partie de l’analyse.
5.2.2 Distribution des réponses JAR
SEDA calcule, pour chaque produit et chaque attribut, les pourcentages de consommateurs Below JAR, JAR et Above JAR. Cette sortie décrit la fréquence des écarts mais ne dit pas encore s’ils réduisent le liking.
5.2.3 Pénalités multidimensionnelles globales
SensoMineR::JAR estime les pénalités à partir de l’ensemble des produits simultanément. Dans SEDA, elles sont présentées sous forme de Mean drop : une valeur positive signifie que le défaut est associé à une perte de liking dans l’espace produit global.
Ces coefficients sont globaux. Ils ne constituent pas une estimation spécifique à chacun des produits. SEDA les combine ensuite avec la fréquence de chaque défaut dans chaque produit dans Global Defects Applied to Each Product.
Une ligne reçoit Priority = Yes lorsque trois conditions sont réunies :
- le pourcentage de consommateurs concernés atteint Consumer threshold (%) ;
- le Global mean drop atteint Mean-drop threshold ;
- la p-value de la pénalité globale est inférieure à 0.05.
Les deux seuils définis dans l’interface sont donc des aides à la décision pratique. Ils ne remplacent pas la p-value.
5.2.4 Pénalité classique spécifique à chaque produit
SEDA calcule également, séparément pour chaque produit, chaque attribut et chaque direction (Below JAR ou Above JAR), la différence :
Mean drop = Mean liking JAR − Mean liking non-JAR
Une valeur positive indique donc que les consommateurs qui perçoivent le défaut donnent en moyenne une note de liking plus faible que ceux qui jugent l’attribut JAR.
Pour chaque comparaison, SEDA fournit :
- le pourcentage de consommateurs concernés ;
- la moyenne de liking du groupe JAR ;
- la moyenne de liking du groupe non-JAR ;
- le Mean drop ;
- son intervalle de confiance à 95 % ;
- la p-value.
Cette analyse est réellement spécifique au produit et complète la pénalité globale.
5.2.5 Synthèse multivariée des défauts
Enfin, SEDA construit un tableau de fréquences produits × modalités non-JAR, le décrit avec descfreq() puis réalise une analyse des correspondances.
La description des produits utilise ici volontairement un seuil exploratoire permissif (proba = 0.5). Elle sert à faire émerger les modalités qui structurent l’espace et ne doit pas être interprétée comme une sélection conventionnelle à 5 %.
La carte d’analyse des correspondances constitue une synthèse de la structure produit × défaut. Comme dans le chapitre CATA, les produits et les défauts doivent être interprétés relativement aux axes factoriels ; une distance directe entre une ligne et une colonne ne se lit pas comme une distance euclidienne ordinaire. La proximité sur cette carte n’est pas, à elle seule, une preuve de pénalité sur le liking.
5.3 Structure des données attendues
Les données doivent contenir :
- une colonne catégorielle pour Stimulus Effect ;
- une colonne catégorielle pour Subject Effect ;
- une colonne numérique pour Liking Variable ;
- une ou plusieurs colonnes nominales pour Sensory Attributes.
Chaque ligne correspond à l’évaluation d’un stimulus par un sujet.
Avant de lancer l’analyse, vérifiez que :
- Stimulus Effect contient au moins deux produits observés ;
- Subject Effect contient au moins deux sujets observés ;
- Liking Variable est numérique et contient suffisamment de valeurs finies ;
- les variables JAR sont définies comme Nominal dans jamovi ;
- chaque attribut JAR contient bien la modalité indiquée dans Coding of the JAR level ;
- chaque attribut JAR possède au moins deux modalités effectivement observées ;
- les variables utilisées pour Stimulus, Subject, Liking et les attributs JAR sont distinctes.
5.4 Guide de l’interface
L’analyse apparaît dans SEDA > Fixed List of Attributes > Analysis of JAR Data. L’interface comporte quatre zones de dépôt de variables, un bloc Instructions and R Code, le champ Coding of the JAR level, puis un bloc Classical Penalty Analysis.
5.4.1 Variables à renseigner
5.4.1.1 Stimulus Effect
Rôle : identifie les produits à analyser. Impact sur le calcul : cette variable définit les produits utilisés dans les analyses globales et spécifiques. Conseil pratique : utilisez des libellés courts et explicites.
5.4.1.2 Subject Effect
Rôle : identifie les sujets. Impact sur le calcul : cette variable est utilisée par l’analyse JAR globale et structure les observations individuelles. Conseil pratique : vérifiez qu’un même sujet conserve le même identifiant dans tout le fichier.
5.4.1.3 Liking Variable
Rôle : contient la note d’appréciation utilisée pour calculer les pénalités. Impact sur le calcul : toutes les pertes de liking sont exprimées dans l’unité de cette variable. Conseil pratique : utilisez la même échelle de liking pour tous les produits.
5.4.1.4 Sensory Attributes
Rôle : regroupe les variables JAR. Impact sur le calcul : chaque variable est utilisée dans les analyses globale, spécifique au produit et multivariée. Conseil pratique : les variables doivent être nominales, même si les modalités traduisent un ordre conceptuel pas assez / JAR / trop.
5.4.2 Instructions and R Code
5.4.2.1 Read me before running
Rôle : affiche l’aide intégrée. Impact sur le calcul : aucun. Elle est activée par défaut.
5.4.2.2 R code
Rôle : affiche le script R reproduisant l’analyse. Impact sur le calcul : aucun. Activez cette option pour poursuivre l’analyse dans le Rj Editor. Elle est désactivée par défaut.
5.4.3 Coding of the JAR level
Rôle : indique le libellé exact de la modalité JAR. Impact sur le calcul : cette modalité sert de référence dans toutes les analyses. Conseil pratique : la valeur par défaut est jar; respectez exactement le libellé présent dans les données.
5.4.4 Classical Penalty Analysis
5.4.4.1 Consumer threshold (%)
Rôle : définit le pourcentage de consommateurs à partir duquel un défaut est considéré comme suffisamment fréquent pour une lecture opérationnelle. Valeur par défaut : 20 %. Point important : ce seuil est une aide à la décision, pas un seuil de significativité.
5.4.4.2 Mean-drop threshold
Rôle : définit la perte de liking à partir de laquelle un effet est considéré comme suffisamment important pour une lecture opérationnelle. Valeur par défaut : 1. Point important : ce seuil porte sur la taille de l’effet, pas sur son incertitude statistique.
5.4.4.3 Below-JAR keywords
Rôle : définit les mots ou expressions utilisés pour reconnaître les modalités situées sous le niveau JAR. La valeur par défaut est too low|not enough|too weak|plain|low.
5.4.4.4 Above-JAR keywords
Rôle : définit les mots ou expressions utilisés pour reconnaître les modalités situées au-dessus du niveau JAR. La valeur par défaut est too high|too much|too strong|vivid|high.
Conseil pratique : commencez toujours par vérifier la table JAR Coding Used for the Classical Penalty Analysis. Si une modalité est Unclassified, adaptez les mots-clés avant d’interpréter les résultats spécifiques aux produits.
5.5 Procédure pas à pas
- Ouvrez le jeu de données dans jamovi.
- Vérifiez que Stimulus Effect et Subject Effect sont catégorielles, Liking Variable numérique et les attributs JAR nominaux.
- Ouvrez SEDA > Fixed List of Attributes > Analysis of JAR Data.
- Renseignez Stimulus Effect, Subject Effect, Liking Variable et Sensory Attributes.
- Vérifiez Coding of the JAR level.
- Laissez Consumer threshold (%) = 20 et Mean-drop threshold = 1 pour une première lecture.
- Vérifiez les expressions Below-JAR keywords et Above-JAR keywords.
- Lisez JAR Coding Used for the Classical Penalty Analysis et corrigez toute modalité Unclassified.
- Lisez Distribution of JAR Responses by Product and Attribute.
- Examinez Global Multidimensional Penalties (All Products) puis Global Defects Applied to Each Product.
- Utilisez Global Penalty Context for Each Product pour visualiser l’exposition de chaque produit aux défauts globalement importants.
- Passez ensuite à Product-Specific Classical Penalty Analysis et aux Product-Specific Penalty Plots.
- Terminez par Description of the Products According to Defects, Representation of the Products and the Defects et Frequency Table Used for the Correspondence Analysis.
- Croisez fréquence, taille du mean drop et incertitude statistique avant de retenir un levier d’optimisation.
5.6 Interprétation des résultats
5.6.1 JAR Coding Used for the Classical Penalty Analysis
Cette table est le contrôle préalable indispensable. Elle indique, pour chaque attribut et chaque modalité originale, si SEDA l’utilise comme Below JAR, JAR, Above JAR ou Unclassified.
Une modalité Unclassified ne doit pas être ignorée : l’attribut correspondant n’entre pas dans l’analyse classique spécifique au produit tant que son codage n’est pas résolu.
5.6.2 Distribution of JAR Responses by Product and Attribute
Cette table donne, pour chaque produit et attribut :
- Below JAR (%) ;
- JAR (%) ;
- Above JAR (%) ;
- N.
Elle répond à la question : combien de consommateurs perçoivent réellement le défaut ? Elle ne mesure pas son impact sur le liking.
5.6.3 Global Multidimensional Penalties (All Products)
Cette table contient les coefficients issus de SensoMineR::JAR :
| Colonne | Interprétation |
|---|---|
| Defect | Modalité non-JAR concernée |
| Mean drop | Perte globale de liking associée au défaut |
| Std. Error | Incertitude de l’estimation |
| p | Évidence statistique associée |
Le Mean drop est présenté de sorte qu’une valeur positive corresponde à une perte de liking.
Point de vigilance : ces coefficients sont estimés sur l’ensemble des produits. Ils ne doivent pas être décrits comme des pénalités propres à un produit.
5.6.4 Global Defects Applied to Each Product
Cette table met en regard, pour chaque produit, la fréquence locale d’un défaut et son Global mean drop.
| Colonne | Interprétation |
|---|---|
| Consumers (%) | Fréquence du défaut dans le produit |
| Global mean drop | Mean drop estimé globalement |
| p | P-value de la pénalité globale |
| Priority | Yes si fréquence, mean drop et p-value satisfont les critères |
Avec les réglages par défaut, Priority = Yes signifie donc : au moins 20 % de consommateurs concernés, un mean drop d’au moins 1 et p < .05.
5.6.5 Global Penalty Context for Each Product
Ces graphiques constituent la visualisation SensoMineR de la pénalité globale replacée dans le contexte de chacun des produits. Ils sont utiles pour voir quels produits sont exposés aux défauts globalement importants, mais l’ordonnée ne devient pas pour autant une pénalité spécifique au produit.
5.6.6 Product-Specific Classical Penalty Analysis
Cette table répond à une autre question : pour ce produit précis, les consommateurs qui perçoivent l’attribut comme non-JAR aiment-ils moins le produit que ceux qui le jugent JAR ?
| Colonne | Interprétation |
|---|---|
| Product | Produit concerné |
| Attribute | Attribut JAR |
| Direction | Below JAR ou Above JAR |
| Consumers (%) | Part de consommateurs dans cette direction |
| Mean liking JAR | Liking moyen du groupe JAR |
| Mean liking non-JAR | Liking moyen du groupe concerné |
| Mean drop | Mean liking JAR − Mean liking non-JAR |
| CI 95% low / high | Intervalle de confiance du mean drop |
| p | P-value du test |
Une valeur positive de Mean drop indique une perte de liking associée au défaut pour ce produit.
5.6.7 Product-Specific Penalty Plots
Pour chaque produit :
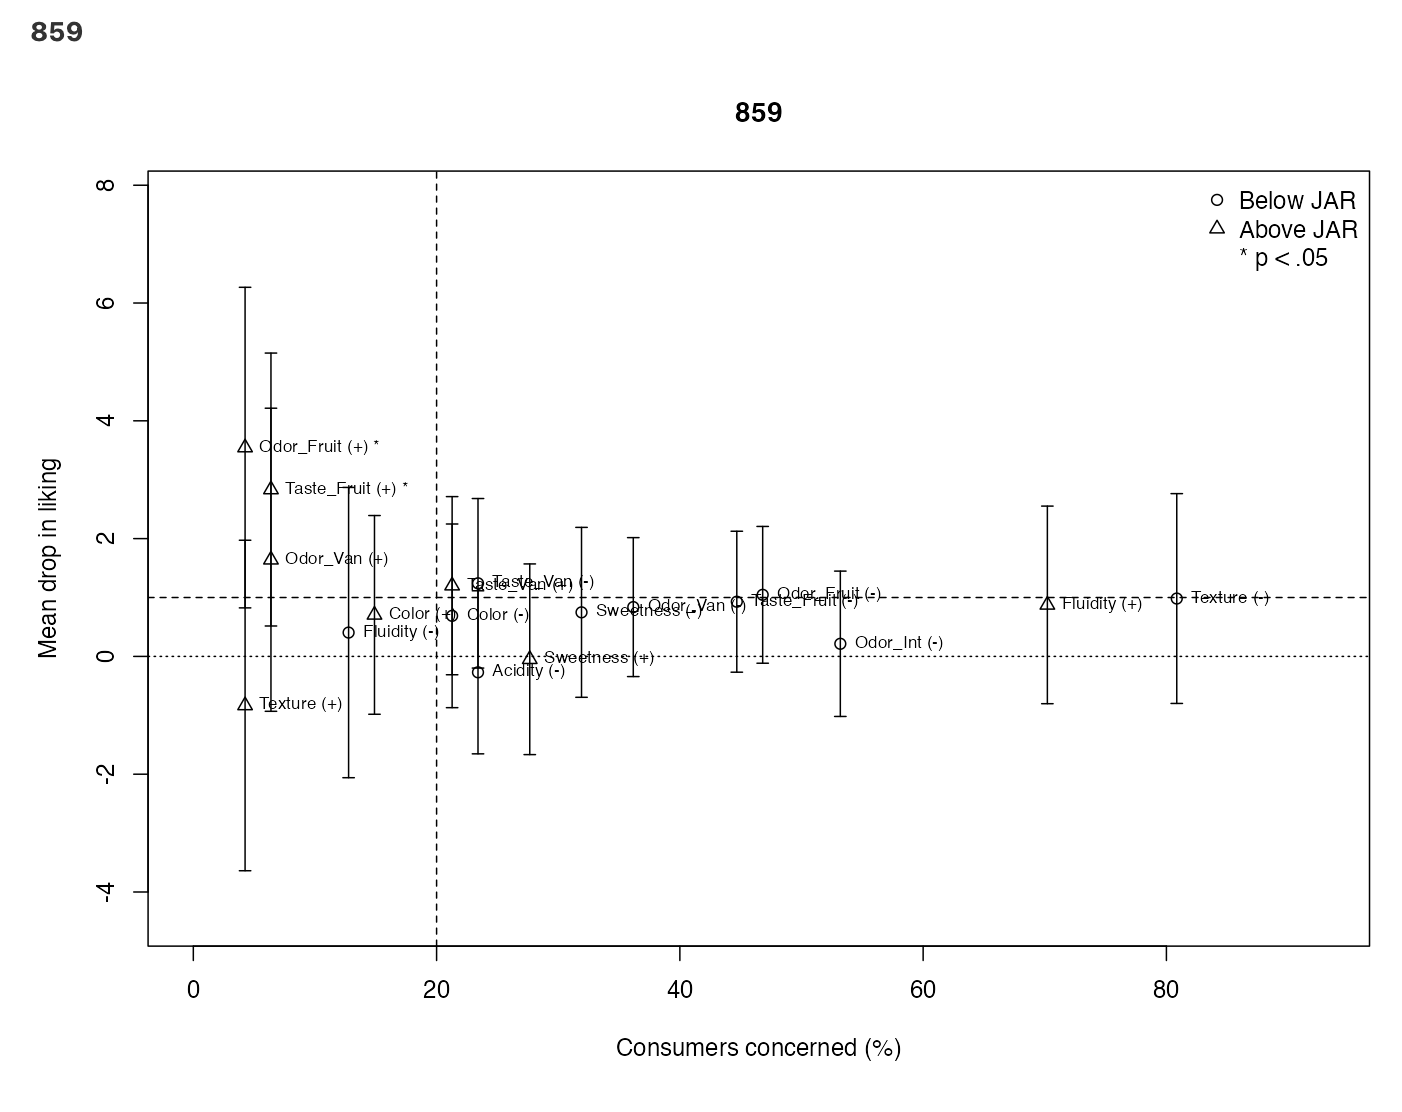
- l’axe des x représente Consumers concerned (%) ;
- l’axe des y représente le Mean drop in liking ;
- la ligne verticale correspond au Consumer threshold ;
- la ligne horizontale correspond au Mean-drop threshold ;
- les symboles distinguent Below JAR et Above JAR ;
*indique p < .05 ;- les segments verticaux représentent l’intervalle de confiance à 95 %.
Un défaut situé dans la zone fréquence élevée / mean drop élevé peut constituer un levier opérationnel, mais l’intervalle de confiance et la p-value doivent rester visibles dans la décision.
5.6.8 Description of the Products According to Defects
Cette table décrit les modalités non-JAR qui structurent le profil de chaque produit. Elle utilise volontairement un seuil exploratoire très permissif dans cette synthèse multivariée. Une modalité affichée avec p > .05 n’est donc pas « significative à 5 % » ; elle est retenue pour aider à lire la structure de l’espace.
5.6.9 Representation of the Products and the Defects
Cette carte provient de l’analyse des correspondances du tableau produits × défauts. Deux produits proches ont des profils de défauts voisins. Pour les relations entre produits et défauts, interprétez surtout les directions et les axes factoriels plutôt qu’une distance directe ligne-colonne.
Cette carte décrit la structure des défauts ; elle ne constitue pas un test de pénalité sur le liking.
5.6.10 Frequency Table Used for the Correspondence Analysis
Cette table contient les fréquences produits × modalités non-JAR utilisées pour descfreq() et l’analyse des correspondances. Elle constitue une sortie d’audit utile pour comprendre exactement les données agrégées qui alimentent la synthèse multivariée.
5.7 Exemple : le jeu de données milkshake
Le jeu de données milkshake porte sur trois milkshakes, 284, 859 et 972, évalués par 47 consommateurs à l’aide de plusieurs attributs JAR liés notamment à la couleur, à la fluidité, aux odeurs, à la sucrosité, à l’acidité, à la texture et au goût. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche, puis sur Open → Data Library → SEDA.
Cet exemple est particulièrement utile parce qu’il montre que les lectures globale et spécifique au produit peuvent conduire à des diagnostics complémentaires.
5.7.1 Paramètres de l’exemple
| Option | Valeur |
|---|---|
| Stimulus Effect | Product |
| Subject Effect | Panelist |
| Liking Variable | Liking |
| Sensory Attributes | toutes les variables JAR de Color à Taste_Van |
| Coding of the JAR level | jar |
| Consumer threshold (%) | 20 |
| Mean-drop threshold | 1 |
| Below-JAR keywords | too low|not enough|too weak|plain|low |
| Above-JAR keywords | too high|too much|too strong|vivid|high|too_fluid |
Figure 5.1 présente la configuration utilisée pour l’exemple JAR.
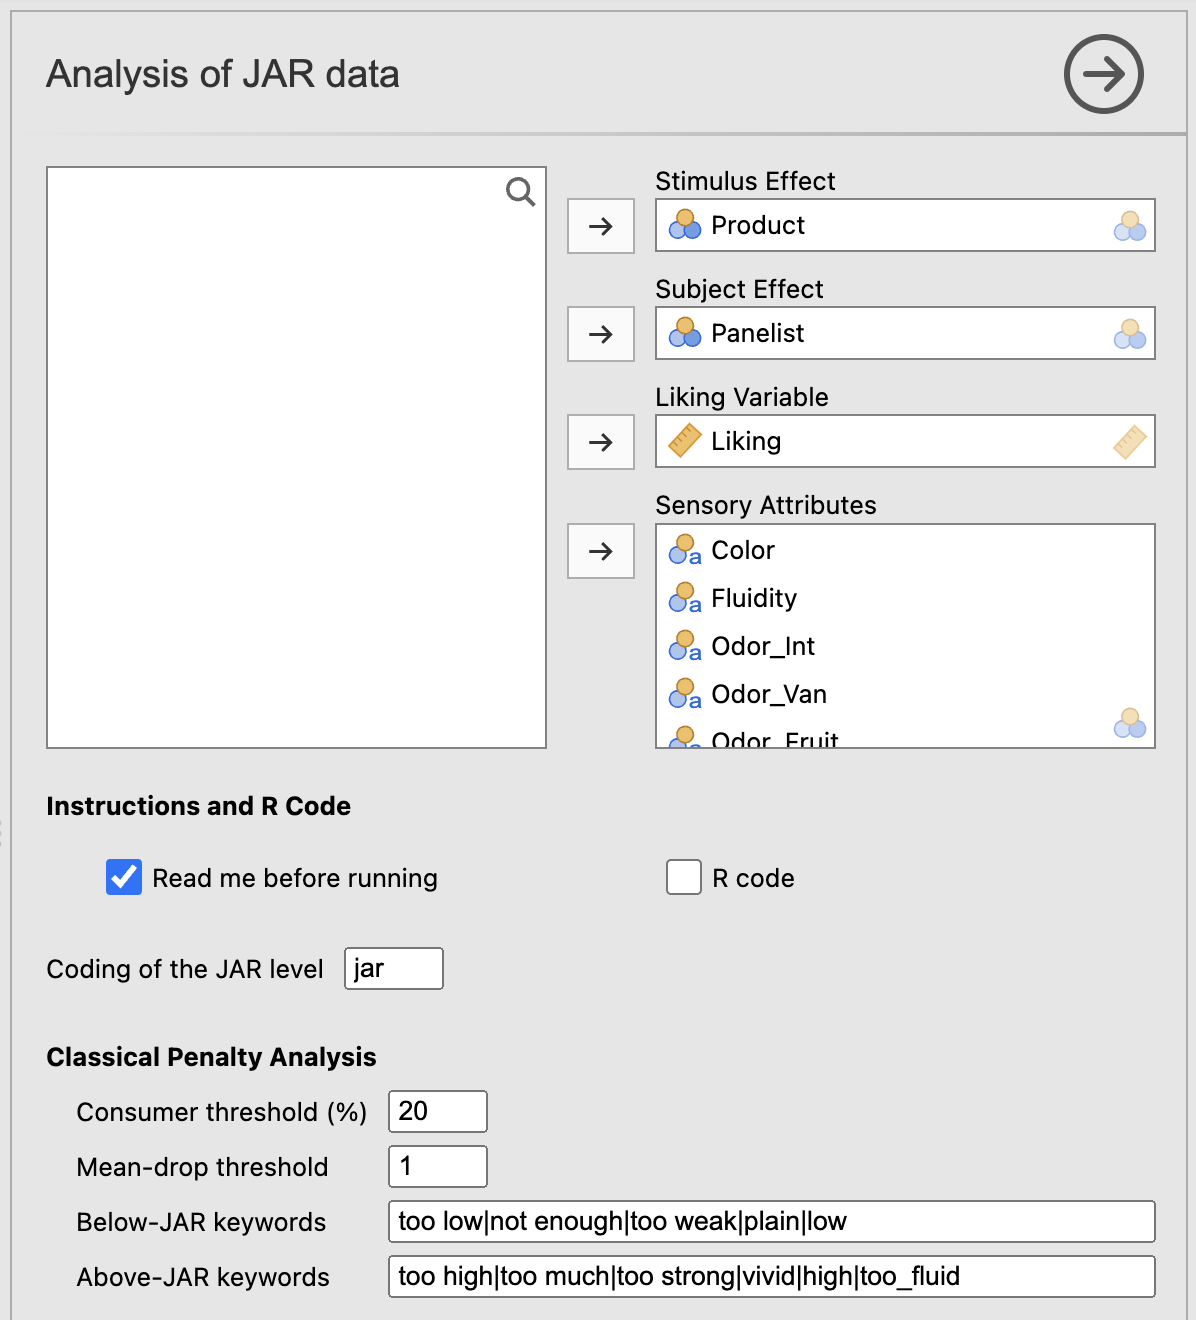
Le dernier terme ajouté à Above-JAR keywords permet de classer correctement la modalité Too_fluid comme Above JAR. SEDA accepte aussi la forme too fluid : les libellés originaux et leur forme normalisée sont désormais tous deux reconnus.
5.7.2 Vérifier d’abord le codage JAR
La table JAR Coding Used for the Classical Penalty Analysis confirme que toutes les modalités utilisées dans cet exemple sont classées en Below JAR, JAR ou Above JAR. Pour Fluidity, Not_enough_fluid est classé Below JAR et Too_fluid Above JAR.
Cette vérification est importante : l’analyse classique spécifique aux produits n’est interprétable que lorsque les modalités non-JAR de l’attribut sont correctement regroupées.
5.7.3 Distribution des réponses JAR
La table Distribution of JAR Responses by Product and Attribute permet de repérer les écarts les plus fréquents.
Pour 284, les réponses Below JAR sont particulièrement fréquentes pour Odor_Van (59.57 %), Texture (57.45 %) et Odor_Int (53.19 %), tandis que 46.81 % des consommateurs jugent Fluidity Above JAR.
Pour 859, deux écarts dominent : 80.85 % des consommateurs sont Below JAR pour Texture et 70.21 % sont Above JAR pour Fluidity.
Pour 972, 55.32 % sont Below JAR pour Odor_Int, 42.55 % sont Above JAR pour Sweetness et 38.30 % sont Above JAR pour Fluidity.
Ces fréquences décrivent la prévalence des écarts. Elles ne suffisent pas à conclure qu’ils font baisser le liking.
5.7.4 Pénalités multidimensionnelles globales
Dans Global Multidimensional Penalties (All Products), un seul défaut est significatif au seuil de 5 % : Too_much_odor_fruit, avec un Mean drop = 2.68 et p = 0.018.
Plusieurs autres effets présentent un mean drop notable sans franchir le seuil de 5 %, par exemple Too_much_acidity (4.02, p = 0.082), Too_much_texture (1.78, p = 0.089) et Not_enough_acidity (1.03, p = 0.087).
Dans SEDA, un Mean drop positif représente une perte de liking.
5.7.5 Global Defects Applied to Each Product
Avec Consumer threshold = 20 % et Mean-drop threshold = 1, aucune ligne n’obtient Priority = Yes.
Too_much_odor_fruit est bien le seul défaut globalement significatif, mais il ne concerne que 6.38 % des consommateurs pour 284, 4.26 % pour 859 et 4.26 % pour 972. Il est donc statistiquement associé à une perte de liking dans l’espace produit global, mais trop rare dans chacun des trois produits pour franchir le seuil pratique de 20 %.
À l’inverse, Too_fluid est très fréquent — 46.81 % pour 284, 70.21 % pour 859 et 38.30 % pour 972 — mais son Global mean drop = 0.45 avec p = 0.275. Fréquence élevée et pénalité globale ne vont donc pas nécessairement de pair.
5.7.6 Pénalités classiques spécifiques au produit
La table Product-Specific Classical Penalty Analysis apporte une lecture directement locale.
Pour 284, plusieurs écarts sont associés à une perte de liking significative :
- Odor_Fruit — Below JAR : 46.81 % des consommateurs, Mean drop = 1.00, IC95 % [0.04 ; 1.96], p = 0.042 ;
- Odor_Fruit — Above JAR : 6.38 %, Mean drop = 2.27, IC95 % [0.47 ; 4.08], p = 0.016 ;
- Sweetness — Below JAR : 21.28 %, Mean drop = 1.22, IC95 % [0.04 ; 2.40], p = 0.044 ;
- Texture — Below JAR : 57.45 %, Mean drop = 1.06, IC95 % [0.10 ; 2.02], p = 0.032.
Pour Fluidity — Above JAR, 46.81 % des consommateurs sont concernés, mais le Mean drop n’est que de 0.69 avec p = 0.182. Le défaut est donc fréquent sans être clairement pénalisant pour 284.
Pour 859, Fluidity — Above JAR fournit un résultat particulièrement instructif : 70.21 % des consommateurs sont concernés, mais le Mean drop vaut seulement 0.87 et p = 0.298. De même, Texture — Below JAR concerne 80.85 % des consommateurs mais présente un Mean drop = 0.98, p = 0.272. Ces deux défauts sont extrêmement fréquents, sans que leur impact hédonique soit clairement établi dans l’analyse spécifique au produit.
Les deux effets significatifs pour 859 concernent au contraire de très petits groupes :
- Odor_Fruit — Above JAR : 4.26 %, Mean drop = 3.55, p = 0.013 ;
- Taste_Fruit — Above JAR : 6.38 %, Mean drop = 2.83, p = 0.019.
Ils sont forts mais rares, ce qui limite leur priorité opérationnelle.
Pour 972, Fluidity — Above JAR concerne 38.30 % des consommateurs avec un Mean drop = 1.06 et p = 0.080 : le signal est compatible avec une perte de liking mais reste insuffisant pour conclure au seuil de 5 %.
Deux autres effets sont significatifs :
- Color — Above JAR : 6.38 %, Mean drop = 2.74, p = 0.009 ;
- Taste_Van — Above JAR : 21.28 %, Mean drop = 1.57, IC95 % [0.19 ; 2.95], p = 0.028.
Le second est particulièrement intéressant, car il combine une fréquence supérieure à 20 %, un mean drop supérieur à 1 et une p-value inférieure à 0.05. Taste_Van — Above JAR constitue ainsi le levier le plus net pour 972.
5.7.7 Ce que montrent les graphiques spécifiques aux produits
Les Product-Specific Penalty Plots rendent cette logique immédiatement visible : la ligne verticale marque 20 % de consommateurs et la ligne horizontale un mean drop de 1.
Pour 284, plusieurs points significatifs se situent dans ou à proximité de la zone supérieure droite, notamment les manques de texture, de sucrosité et d’odeur fruitée.
Pour 859, Fluidity — Above JAR et Texture — Below JAR sont très à droite du graphique, donc très fréquents, mais restent sous ou autour du seuil de mean drop et ne sont pas significatifs. Les deux effets significatifs ont au contraire de grands mean drops mais se situent très à gauche, car ils concernent peu de consommateurs.
Figure 5.2 montre la pénalité spécifique au produit 859.
Pour 972, Taste_Van — Above JAR combine fréquence, taille d’effet et évidence statistique, tandis que Fluidity — Above JAR constitue un signal plus incertain.
Figure 5.3 montre la pénalité spécifique au produit 972.
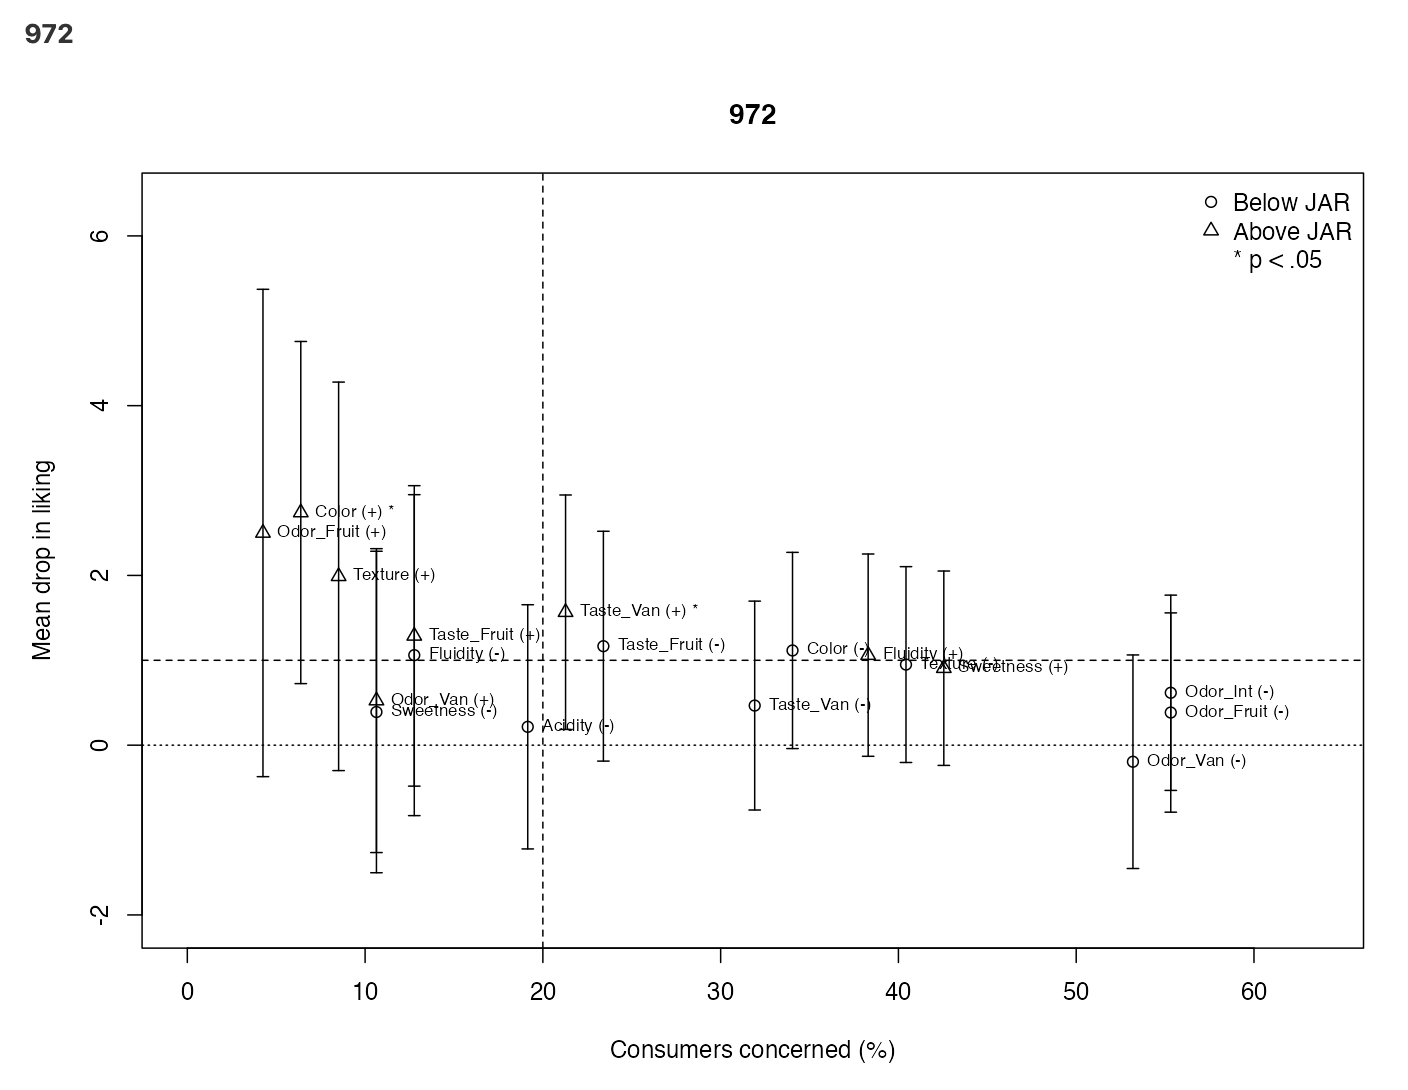
Ces graphiques montrent pourquoi fréquence, taille d’effet et incertitude doivent être considérées simultanément.
5.7.8 Synthèse multivariée des défauts
La table Description of the Products According to Defects utilise le seuil exploratoire proba = 0.5. Les lignes affichées ne doivent donc pas toutes être qualifiées de « significatives à 5 % ».
Le produit 859 est surtout orienté vers Texture = Not_enough_texture (V-test = 1.92, p = 0.055) et Fluidity = Too_fluid (1.75, p = 0.080), tandis que Color = A_little_plain (-2.05, p = 0.040) et Odor_Van = Not_enough_odor_van (-1.97, p = 0.049) sont sous-représentés.
Le produit 972 est notamment orienté vers Sweetness = Too_much_sweetness (V-test = 1.71, p = 0.087), alors que Texture = Not_enough_texture est sous-représenté (V-test = -1.80, p = 0.072).
Le produit 284 présente une structure moins marquée ; sa modalité positive la plus nette est Color = A_little_plain (V-test = 1.32, p = 0.187).
5.7.9 Representation of the Products and the Defects
Figure 5.4 montre la structure factorielle des produits et des défauts.
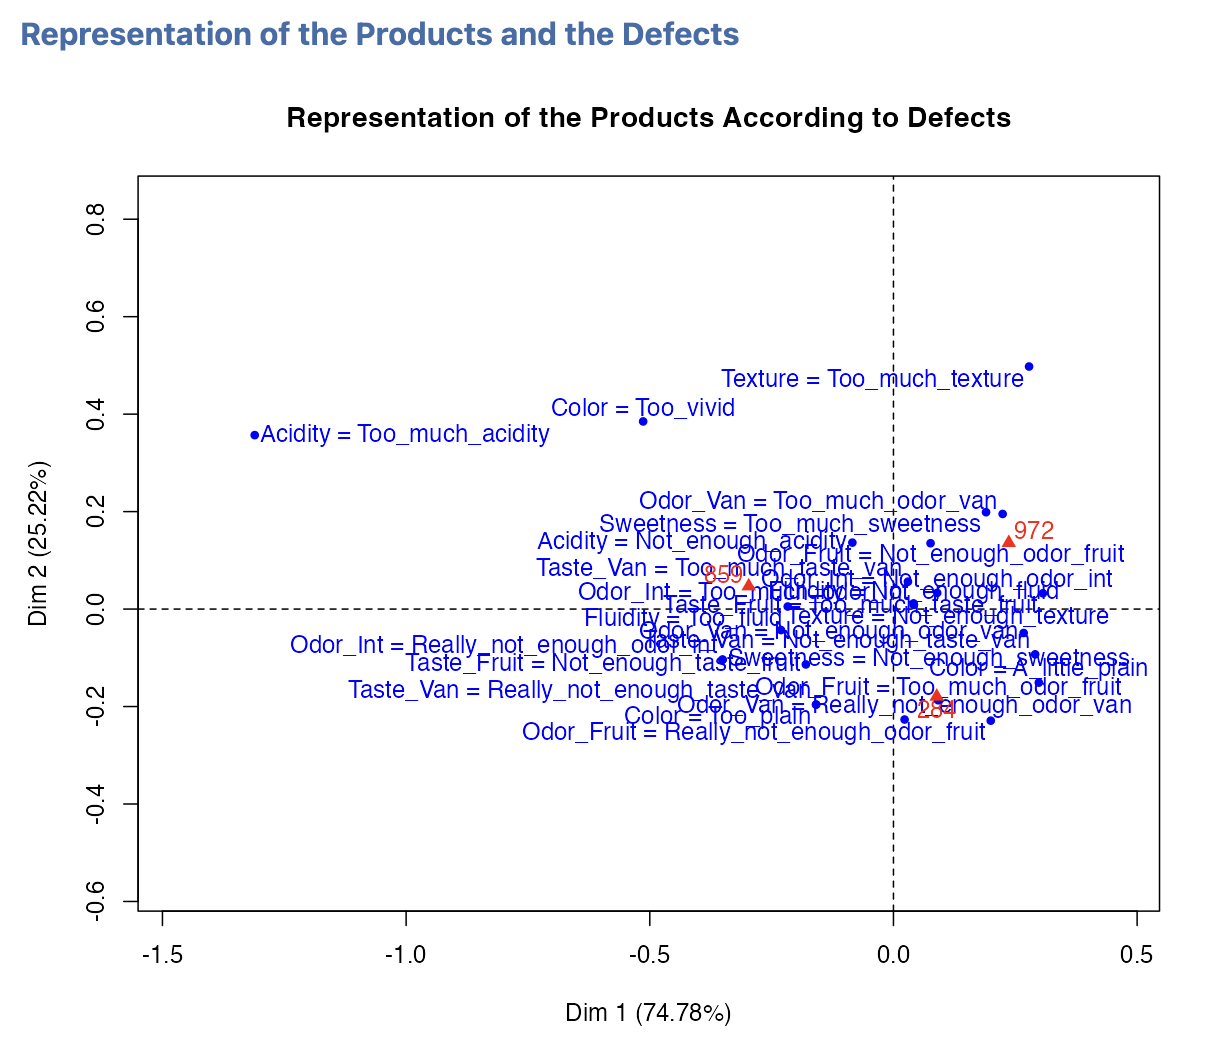
L’analyse des correspondances est entièrement résumée par les deux dimensions disponibles : Dim. 1 = 74.78 % et Dim. 2 = 25.22 %.
La Dim. 1 oppose principalement 859 et 972, tandis que 284 occupe une position plus intermédiaire. Cette carte synthétise la structure des profils non-JAR, mais les associations produit–défaut doivent être interprétées relativement aux axes et non à partir d’une simple proximité géométrique ligne-colonne.
5.7.10 Interprétation synthétique
Cet exemple montre surtout que les différentes informations de l’analyse JAR ne sont pas redondantes.
La vue globale identifie Too_much_odor_fruit comme le seul défaut clairement associé à une perte de liking dans l’ensemble de l’espace produit, mais ce défaut est trop rare dans chacun des produits pour devenir une priorité avec le seuil de 20 %.
La vue spécifique au produit montre au contraire que des défauts extrêmement fréquents peuvent être peu ou non pénalisants : c’est le cas de Too_fluid et de Not_enough_texture pour 859. Elle fait aussi apparaître des leviers locaux, notamment plusieurs défauts pour 284 et surtout Taste_Van — Above JAR pour 972.
Ce qu’on retient de cet exemple : une analyse JAR utile ne consiste pas à chercher « le défaut le plus pénalisant ». Elle distingue ce qui est fréquent, ce qui est globalement pénalisant, ce qui est spécifiquement pénalisant pour un produit, et ce qui combine suffisamment fréquence, taille d’effet et évidence statistique pour devenir une priorité d’optimisation.
5.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code. Le script généré charge SensoMineR et FactoMineR, et utilise le jeu de données actuellement ouvert dans jamovi sous le nom data.
Le code reproduit successivement la pénalité multidimensionnelle globale avec JAR(), le diagnostic classique spécifique à chaque produit, puis la synthèse produits × défauts avec descfreq() et CA(). Il reprend également les seuils et les mots-clés définis dans l’interface.
Les appels graphiques sont écrits de manière à produire des sorties séparées dans le Rj Editor pour chaque produit. Aucun réglage supplémentaire n’est nécessaire.
5.9 Conseils pratiques
- Vérifiez toujours JAR Coding Used for the Classical Penalty Analysis avant d’interpréter les pénalités spécifiques aux produits.
- Les variables JAR doivent être définies comme Nominal dans jamovi et contenir exactement le niveau indiqué dans Coding of the JAR level.
- Une modalité Unclassified signale un problème de regroupement Below/Above JAR : adaptez les mots-clés avant de poursuivre l’interprétation classique.
- Ne confondez pas les deux lectures : Global Multidimensional Penalties décrit l’espace produit dans son ensemble ; Product-Specific Classical Penalty Analysis répond séparément pour chaque produit.
- Un Mean drop positif indique une perte de liking. Interprétez sa taille avec le pourcentage de consommateurs concernés, l’intervalle de confiance et la p-value.
- Consumer threshold (%) et Mean-drop threshold sont des seuils pratiques de décision, pas des seuils de significativité.
- Un défaut fréquent n’est pas nécessairement pénalisant ; un défaut fortement pénalisant mais très rare n’est pas nécessairement prioritaire.
- Utilisez la carte d’analyse des correspondances pour comprendre la structure des profils de défauts, pas pour conclure à un effet sur le liking.
5.10 En résumé
Utilisez cette analyse lorsque vous disposez de réponses JAR associées à une mesure de liking et que vous souhaitez identifier les écarts au niveau idéal susceptibles de guider l’optimisation produit.
SEDA commence par vérifier le codage JAR, décrit ensuite la fréquence des réponses Below/JAR/Above, puis fournit deux lectures complémentaires : une pénalité globale sur l’ensemble de l’espace produit et une pénalité classique spécifique à chaque produit. La synthèse multivariée par analyse des correspondances complète ces diagnostics en montrant comment les produits se structurent selon leurs modalités non-JAR.
Lisez donc d’abord le codage et les distributions, puis les pénalités globales, ensuite les pénalités spécifiques aux produits, et terminez par la synthèse factorielle.
Retenez surtout qu’une priorité d’optimisation ne repose pas sur un seul seuil : elle doit combiner fréquence du défaut, taille du mean drop et incertitude statistique.