3 Données QDA — Représentation multivariée avec ellipses
3.1 Introduction
Cette analyse est conçue pour les données de type Quantitative Descriptive Analysis (QDA), c’est-à-dire lorsque plusieurs sujets évaluent plusieurs stimuli à l’aide d’une liste fixe d’attributs sensoriels. Elle prolonge la caractérisation univariée de l’espace sensoriel en proposant une représentation multivariée des stimuli et de leur variabilité. Elle répond à deux questions complémentaires : quels stimuli se ressemblent sensoriellement et cette proximité est-elle stable malgré la variabilité entre sujets ? Son résultat central est une carte des stimuli enrichie d’ellipses, qui visualisent non seulement la position des stimuli, mais aussi la robustesse de cette position face au rééchantillonnage du panel.
Pourquoi ne pas utiliser une alternative standard ?
Une ACP appliquée directement aux données brutes risque de mélanger deux sources de variation : l’effet stimulus et l’effet sujet. Or, en analyse sensorielle, certains sujets notent systématiquement plus haut ou plus bas que les autres, ou utilisent l’échelle de façon plus ou moins large. Cette analyse tient compte de cette structure sujet/stimulus pour produire une représentation plus adaptée aux données QDA.
3.2 Comprendre ce qui se passe “sous le capot”
3.2.1 Sélection des attributs sensoriels
Avant de construire la carte, la fonction identifie les attributs qui discriminent suffisamment les stimuli. Cette sélection dépend de la valeur de Descriptor selection threshold (%). Plus le seuil est strict, plus la carte sera épurée ; plus il est large, plus la représentation sera exhaustive, mais parfois plus chargée. La valeur par défaut est 20 %, ce qui en fait un bon point de départ pour l’exploration.
3.2.2 Correction de l’effet sujet
Une manière simple de comprendre l’étape suivante est de dire que l’analyse reconstruit des profils sensoriels moyens par stimulus, en tenant compte des différences entre sujets. Deux options interviennent ici :
- Center by subject corrige les différences de niveau moyen entre sujets ;
- Scale by subject corrige les différences d’amplitude d’utilisation de l’échelle.
L’objectif est d’éviter qu’un sujet très généreux, très sévère, ou très “étalé” dans ses réponses déforme artificiellement la carte des stimuli.
3.2.3 Analyse en composantes principales
Une ACP est ensuite réalisée sur le tableau des profils sensoriels ainsi obtenu. Elle produit la carte des stimuli, la carte des attributs sensoriels, le tableau des valeurs propres et la description automatique des dimensions. C’est cet espace factoriel qui sert ensuite de référence pour projeter les panels virtuels.
3.2.4 Panels virtuels et individus supplémentaires
Le point clé de la fonction est l’usage du rééchantillonnage. En ACP, il est possible de distinguer les individus actifs — ceux qui servent à construire les axes — des individus supplémentaires — ceux qui sont projetés après coup, sans modifier les axes. C’est précisément ce mécanisme qui permet de construire les ellipses.
À chaque simulation, un sous-ensemble de sujets est tiré avec remise depuis le panel original, de nouveaux profils moyens de stimuli sont recalculés, puis projetés dans l’espace factoriel comme individus supplémentaires. La dispersion de ces projections autour de chaque stimulus est ensuite résumée par une ellipse.
Ces ellipses décrivent donc la variabilité de la position moyenne des stimuli quand la composition du panel change, et non la simple dispersion brute des notes individuelles.
Remarque : le calcul peut prendre quelques secondes, car il repose sur un grand nombre de panels virtuels. Pendant ce calcul, mieux vaut éviter de modifier d’autres options pour ne pas relancer inutilement la procédure.
3.2.5 Comparaison entre stimuli
La fonction calcule aussi une comparaison entre paires de stimuli, présentée sous forme de matrice de p-values. Le test de Hotelling porte sur le plan factoriel sélectionné par X-axis et Y-axis. Cette sortie complète la lecture visuelle des ellipses ; les comparaisons sont exploratoires et ne sont pas ajustées pour multiplicité.
3.2.6 Description automatique des dimensions
La fonction propose enfin une description automatique des axes, filtrée selon la valeur de Significance threshold (%). Elle aide à identifier quels attributs sont les plus associés à chaque dimension et à donner un sens sensoriel aux axes.
3.3 Structure des données attendues
Les données doivent contenir :
- une colonne identifiant les stimuli ;
- une colonne identifiant les sujets ;
- au moins deux colonnes numériques correspondant aux attributs sensoriels.
Chaque ligne correspond à l’évaluation d’un stimulus par un sujet. Si un sujet évalue plusieurs fois un même stimulus (répétitions ou sessions), chaque évaluation doit apparaître sur une ligne distincte.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- la variable destinée à Stimulus Effect est bien catégorielle ;
- la variable destinée à Subject Effect est bien catégorielle ;
- toutes les variables destinées à Sensory Attributes sont numériques.
3.4 Guide de l’interface
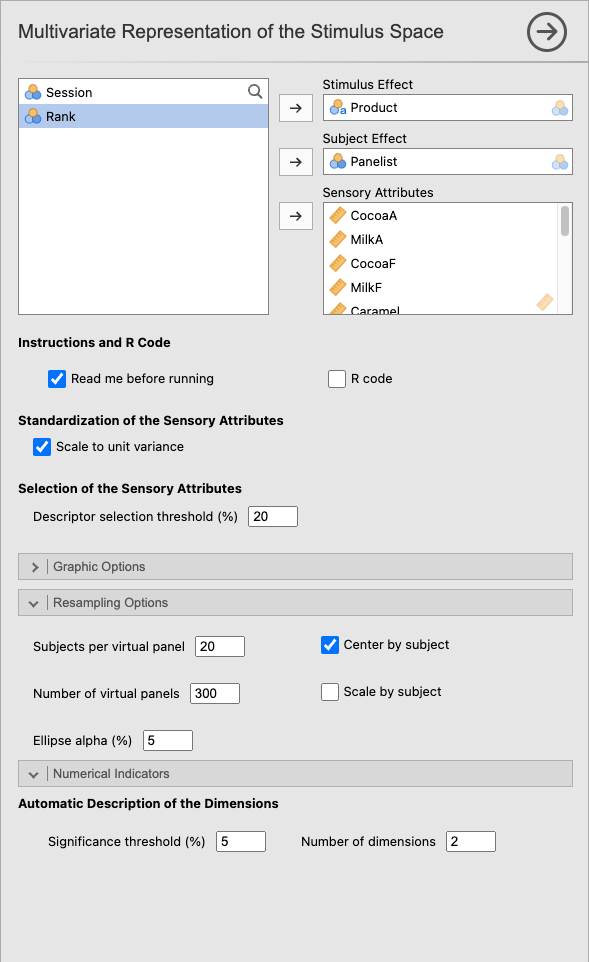
L’analyse apparaît dans le menu SEDA > Fixed List of Attributes > Representation of the Stimulus Space. L’interface comporte trois zones de dépôt de variables, un bloc Instructions and R Code contenant les cases Read me before running et R code, puis trois menus repliables : Graphic Options, Resampling Options et Numerical Indicators.
3.4.1 Variables à renseigner
3.4.1.1 Stimulus Effect
Rôle : identifie les stimuli à représenter sur la carte. Impact sur le calcul : chaque modalité de cette variable devient un point moyen et, le cas échéant, une ellipse sur la carte. Conseil pratique : utilisez des libellés clairs, car ils apparaîtront directement dans les graphiques.
3.4.1.2 Subject Effect
Rôle : identifie les sujets. Impact sur le calcul : cette variable est indispensable pour corriger l’effet sujet et pour générer les panels virtuels utilisés dans le bootstrap. Conseil pratique : vérifiez qu’un même sujet conserve exactement le même identifiant dans tout le fichier.
3.4.1.3 Sensory Attributes
Rôle : regroupe les attributs sensoriels utilisés pour construire l’espace factoriel. Impact sur le calcul : seuls des attributs numériques sont acceptés ; le nombre de dimensions calculables dépend du nombre d’attributs retenus. Conseil pratique : commencez par inclure tous les attributs sensoriels pertinents, puis affinez avec Descriptor selection threshold (%).
3.4.2 Instructions and R Code
3.4.2.1 Read me before running
Rôle : affiche une aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez-la cochée lors des premières utilisations. Elle est activée par défaut.
3.4.2.2 R code
Rôle : affiche le script R correspondant à l’analyse dans une sortie R Code. Impact sur le calcul : aucun. Conseil pratique : activez cette option pour reproduire l’analyse dans le Rj Editor ou poursuivre le travail dans R. Elle est désactivée par défaut.
3.4.3 Standardization of the Sensory Attributes: Scale to unit variance
Rôle : standardise les attributs sensoriels au moment de l’ACP. Impact sur le calcul : cochée, chaque attribut contribue de la même manière à la construction des axes ; décochée, les attributs les plus dispersés influencent davantage la construction des axes. Conseil pratique : laissez cette option cochée dans la plupart des analyses. Elle est activée par défaut.
3.4.4 Selection of the Sensory Attributes : Descriptor selection threshold (%)
Rôle : fixe le seuil de sélection des attributs selon leur lien avec l’effet stimulus. Impact sur le calcul : un seuil faible retient peu d’attributs et produit une carte plus lisible ; un seuil plus élevé retient davantage d’attributs et donne une vision plus large. Conseil pratique : la valeur par défaut est 20 %, bon point de départ pour explorer. Pour une version plus stricte, commencez à 5 %.
3.4.5 Graphic Options
3.4.5.1 Components to Plot — X-axis et Y-axis
Rôle : choisissent les dimensions affichées en abscisse et en ordonnée. Impact sur le calcul : ne changent pas l’ACP elle-même, mais modifient le plan factoriel affiché. Les dimensions sélectionnées doivent exister dans l’analyse, sinon la fonction génère une erreur. Conseil pratique : commencez avec X-axis = 1 et Y-axis = 2, valeurs par défaut.
3.4.5.2 Individual variability around stimuli
Rôle : ajoute un graphique montrant la dispersion des évaluations individuelles autour de chaque stimulus. Impact sur le calcul : n’ajoute pas une nouvelle analyse, mais une sortie graphique supplémentaire utile pour juger le consensus entre sujets. Conseil pratique : activez cette option si vous souhaitez distinguer un stimulus consensuel d’un stimulus perçu de façon plus variable. La valeur par défaut est désactivée.
3.4.5.3 Variability around sensory attributes
Rôle : ajoute un graphique montrant la variabilité des attributs sensoriels sous rééchantillonnage. Impact sur le calcul : fournit une sortie graphique utile pour juger la stabilité de l’interprétation des attributs. Conseil pratique : activez cette option lorsque vous souhaitez commenter la robustesse des axes. La valeur par défaut est désactivée.
3.4.6 Resampling Options
3.4.6.1 Subjects per virtual panel
Rôle : définit le nombre de sujets tirés dans chaque panel virtuel. Impact sur le calcul : plus cette valeur est proche de l’effectif réel du panel, plus les panels simulés lui ressemblent. Conseil pratique : utilisez l’effectif réel du panel comme point de départ. La valeur par défaut est 20.
3.4.6.2 Number of virtual panels
Rôle : fixe le nombre total de panels virtuels simulés. Impact sur le calcul : plus ce nombre est grand, plus les ellipses sont stables d’une exécution à l’autre, mais le temps de calcul augmente. Conseil pratique : 300 est un bon compromis pour commencer ; pour un rendu final, il peut être utile d’augmenter ce nombre à 500. La valeur par défaut est 300.
3.4.6.3 Ellipse alpha (%)
Rôle : définit le niveau alpha utilisé pour tracer les ellipses de confiance. Impact sur le calcul : un alpha plus faible produit des ellipses plus larges ; avec la valeur par défaut de 5 %, l’ellipse correspond à un niveau de 95 % dans la construction fondée sur la covariance des positions simulées. Conseil pratique : laissez 5 % pour un premier essai.
3.4.6.4 Center by subject
Rôle : centre les réponses sujet par sujet. Impact sur le calcul : corrige les différences de niveau moyen entre sujets et améliore souvent la comparaison entre profils. Conseil pratique : laissez cette option cochée dans la quasi-totalité des analyses. Elle est activée par défaut.
3.4.6.5 Scale by subject
Rôle : standardise les réponses sujet par sujet. Impact sur le calcul : corrige les différences d’amplitude entre sujets, mais modifie plus fortement la structure initiale que le centrage seul. Conseil pratique : laissez cette option décochée dans un premier temps. Elle est désactivée par défaut.
3.4.7 Numerical Indicators
3.4.7.1 Significance threshold (%)
Rôle : définit le seuil de significativité pour la description automatique des dimensions. Impact sur le calcul : plus le seuil est strict, plus la description automatique est sélective. Conseil pratique : la valeur par défaut, 5 %, convient bien à une première lecture.
3.4.7.2 Number of dimensions
Rôle : définit le nombre de dimensions incluses dans la description automatique. Impact sur le calcul : SEDA calcule suffisamment de composantes pour décrire ces dimensions ; le plan affiché reste choisi séparément avec X-axis et Y-axis. Conseil pratique : la valeur par défaut, 2, est adaptée à une lecture initiale.
3.5 Procédure pas à pas
- Ouvrez votre jeu de données dans jamovi.
- Dans l’onglet Données, vérifiez que la variable stimulus est catégorielle, la variable sujet est catégorielle, et que les attributs sensoriels sont numériques.
- Ouvrez SEDA > Fixed List of Attributes > Representation of the Stimulus Space.
- Placez la variable stimulus dans Stimulus Effect.
- Placez la variable sujet dans Subject Effect.
- Placez tous les attributs sensoriels dans Sensory Attributes.
- Laissez Scale to unit variance coché.
- Réglez Descriptor selection threshold (%) à 20 % pour une exploration initiale, ou à 5 % pour une sélection plus stricte.
- Conservez X-axis = 1 et Y-axis = 2.
- Laissez Center by subject coché et Scale by subject décoché au départ.
- Réglez Subjects per virtual panel sur l’effectif du panel ou une valeur proche, laissez Number of virtual panels à 300 et Ellipse alpha (%) à 5.
- Activez Individual variability around stimuli et/ou Variability around sensory attributes selon vos besoins.
- Dans Numerical Indicators, gardez les valeurs par défaut pour un premier essai.
- Lisez d’abord Representation of the Stimuli et Representation of the Sensory Attributes, puis Eigenvalue Decomposition et Automatic Description of the Dimensions. Évaluez ensuite la stabilité avec Representation of the Stimuli with Confidence Ellipses et Hotelling Test.
- Revenez ensuite sur les réglages pour tester la stabilité de vos conclusions.
3.6 Interprétation des résultats
3.6.1 Representation of the Stimuli with Confidence Ellipses
C’est le graphique central de la fonction. Chaque stimulus est représenté par un point moyen dans l’espace factoriel, entouré d’une ellipse. Les axes sont issus de l’ACP, et le pourcentage affiché sur chaque axe indique la part de variance expliquée.
| Élément | Signification |
|---|---|
| Deux stimuli proches | Profils sensoriels similaires |
| Ellipses très chevauchantes | Séparation visuelle moins nette sous rééchantillonnage |
| Ellipse petite | Position stable selon les panels simulés |
| Ellipse grande | Position plus incertaine |
| Ellipses bien séparées | Séparation visuelle plus nette sous rééchantillonnage |
Point de vigilance : les ellipses décrivent la variabilité de la position moyenne des stimuli sous rééchantillonnage du panel. Elles ne représentent pas directement la dispersion brute des notes individuelles. Leur chevauchement constitue un repère visuel, pas un test de significativité ; utilisez le Hotelling Test pour la comparaison statistique paire par paire.
3.6.2 Representation of the Stimuli
Cette carte montre les positions relatives des stimuli sans mettre l’accent sur les ellipses. Elle est utile pour repérer rapidement les regroupements et les oppositions majeures entre stimuli.
3.6.3 Representation of the Sensory Attributes
Cette carte montre les attributs sensoriels dans l’espace factoriel. On la lit selon trois repères simples :
- la direction : vers quels stimuli l’attribut “tire” la structure ;
- la longueur : plus un attribut est long, mieux il est représenté sur le plan ;
- l’angle entre deux attributs : petit angle = corrélation positive ; angle proche de 180° = opposition ; angle proche de 90° = quasi-indépendance.
C’est cette carte qui permet de donner un sens sensoriel aux axes.
3.6.4 Individual variability around stimuli (disponible uniquement si l’option est activée)
Cette sortie montre la dispersion des évaluations individuelles autour du point moyen de chaque stimulus. Un nuage compact indique un fort consensus ; un nuage dispersé indique une perception plus hétérogène entre sujets.
3.6.5 Variability of the Sensory Attributes (disponible uniquement si l’option est activée)
Cette sortie montre la dispersion de la position des attributs sensoriels dans les panels virtuels. Un nuage compact signifie que l’attribut est stable ; un nuage dispersé indique que son interprétation est plus fragile et dépend davantage de la composition du panel.
3.6.6 Eigenvalue Decomposition
Ce tableau donne, pour chaque dimension, la valeur propre, le pourcentage de variance expliqué et le pourcentage cumulé. Si les deux premières dimensions expliquent une grande part de la variance, la carte 2D résume bien les données. Dans le cas contraire, il est prudent d’explorer d’autres plans, par exemple Dim 1 / Dim 3.
3.6.7 Automatic Description of the Dimensions
Ce tableau identifie les attributs les plus liés à chaque dimension, filtrés par Significance threshold (%). Il indique notamment leur corrélation avec la dimension et la p-value associée. Une dimension demandée dans Number of dimensions peut ne pas apparaître si aucun attribut n’atteint le seuil de significativité choisi. Le tableau aide à donner un sens sensoriel aux axes et complète la carte des attributs.
3.6.8 Hotelling Test
Cette matrice de p-values compare chaque paire de stimuli sur le plan factoriel sélectionné par X-axis et Y-axis. Une p-value faible apporte des éléments en faveur d’une séparation entre deux stimuli sur ce plan ; une p-value élevée ne permet pas d’établir cette séparation. Ces comparaisons paire par paire sont exploratoires et ne font pas l’objet d’un ajustement pour multiplicité. Le tableau complète donc la lecture visuelle des ellipses sans s’y substituer.
3.7 Exemple : le jeu de données sensochoc
Le jeu de données sensochoc décrit 6 chocolats évalués par 29 sujets sur 14 attributs sensoriels. Il sert à illustrer les sorties de la fonction. Les valeurs numériques et les graphiques commentés ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
3.7.1 Paramètres de l’exemple
Pour reproduire cet exemple, voici les valeurs à utiliser.
| Option | Valeur |
|---|---|
| Stimulus Effect | Product |
| Subject Effect | Panelist |
| Sensory Attributes | tous les attributs sensoriels |
| Scale to unit variance | Coché |
| Descriptor selection threshold (%) | 20 |
| X-axis / Y-axis | 1 / 2 |
| Subjects per virtual panel | 20 |
| Number of virtual panels | 300 |
| Ellipse alpha (%) | 5 |
| Center by subject | Coché |
| Scale by subject | Décoché |
| Significance threshold (%) | 5 |
| Number of dimensions | 2 |
Remarque de reproductibilité : les résultats numériques et les graphiques issus du rééchantillonnage commentés ci-dessous ont été obtenus avec la valeur par défaut Subjects per virtual panel = 20. Utilisez 20 pour reproduire exactement ce chapitre. Comme le panel réel comporte 29 sujets, 29 constitue un choix naturel pour une nouvelle analyse finale ; modifier cette valeur modifie les sorties fondées sur le rééchantillonnage.
Figure 3.1 récapitule la configuration utilisée pour cet exemple.
3.7.2 Analyse du graphique Representation of the Stimuli with Confidence Ellipses
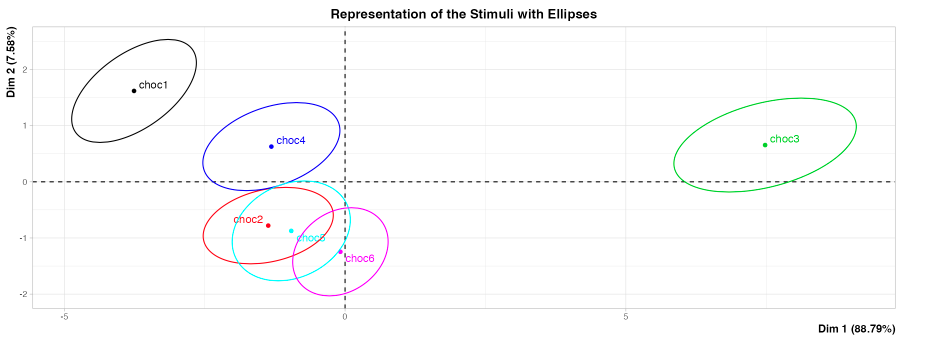
Figure 3.2 montre les 6 chocolats dans le plan Dim. 1 / Dim. 2. La première dimension concentre à elle seule 88.79 % de la variance totale — ce plan 2D est donc une représentation très fidèle des données. La deuxième dimension n’en explique que 7.58 % supplémentaires.
Sur l’axe horizontal (Dim. 1), choc1 et choc3 occupent les deux extrémités opposées : choc1 à gauche (côté amer, cacaoté), choc3 à droite (côté lacté, sucré). Ce sont les deux chocolats dont les profils s’opposent le plus nettement, ce qui est cohérent avec les résultats du chapitre précédent. choc2, choc5 et choc6 sont regroupés au centre, près de l’origine. choc4 se situe légèrement au-dessus de l’axe horizontal, entre choc1 et le groupe central.
Les ellipses renseignent sur la robustesse de ces positions. Les ellipses de choc2, choc5 et choc6 se chevauchent largement : leur séparation visuelle est donc moins nette lorsque la composition du panel varie. À l’opposé, choc1 et choc3 ont des ellipses nettement séparées de tout le reste : leur séparation visuelle paraît robuste aux panels simulés. Le Hotelling Test permet ensuite d’évaluer statistiquement ces différences sur le plan affiché.
3.7.3 Analyse du tableau Hotelling Test
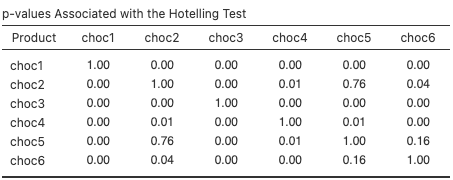
Figure 3.3 présente les p-values qui complètent quantitativement la lecture des ellipses sur le plan Dim. 1 / Dim. 2. Les paires choc2 / choc5 (p = 0.76) et choc5 / choc6 (p = 0.16) présentent des p-values élevées : on ne met pas en évidence de séparation entre ces chocolats sur ce plan. La paire choc2 / choc6 est plus limite (p = 0.04). En revanche, toutes les comparaisons impliquant choc1 ou choc3 donnent des p-values de 0.00 dans les résultats de cet exemple. Ces comparaisons paire par paire sont exploratoires et ne sont pas ajustées pour multiplicité.
3.7.4 Analyse du graphique Representation of the Sensory Attributes
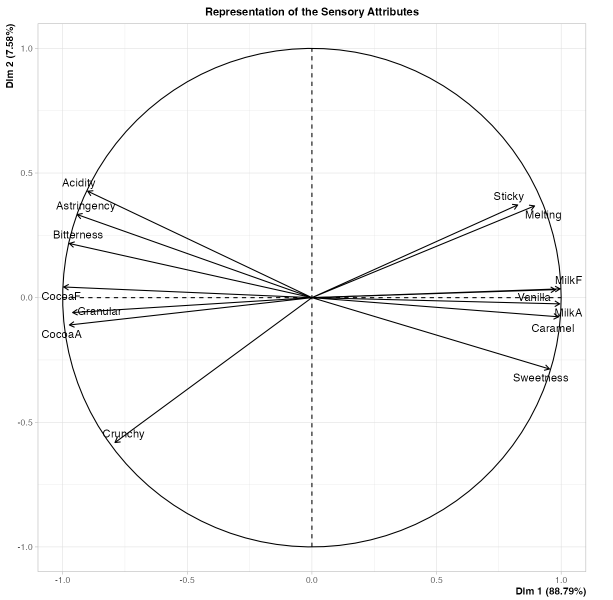
Figure 3.4 montre les 14 attributs distribués autour de l’axe horizontal. À droite se regroupent MilkF, Sweetness, Caramel, Vanilla, MilkA et Melting — c’est le profil de choc3. À gauche se regroupent CocoaF, CocoaA, Bitterness, Astringency, Acidity, Crunchy et Granular — c’est le profil de choc1. L’axe horizontal correspond donc clairement à une opposition chocolat au lait sucré / chocolat noir amer.
La longueur des flèches indique aussi la qualité de représentation de chaque attribut sur ce plan. Crunchy a une flèche plus courte et orientée vers le bas, ce qui indique qu’il est moins bien représenté sur ce plan que CocoaF ou MilkF, dont les flèches atteignent presque le bord du cercle. Cette longueur ne renseigne pas, à elle seule, sur la stabilité de l’attribut entre panels ; cette question relève du graphique Variability of the Sensory Attributes.
3.7.5 Analyse du tableau Automatic Description of the Dimensions
La description automatique des dimensions confirme l’opposition très marquée portée par la Dim. 1. Les attributs les plus corrélés positivement sont MilkF (1.00), MilkA (0.99), Caramel (0.99), Vanilla (0.98) et Sweetness (0.95). À l’opposé, les corrélations les plus négatives concernent CocoaF (-1.00), Bitterness (-0.97), CocoaA (-0.97), Granular (-0.96) et Astringency (-0.94). Avec Significance threshold (%) = 5, aucun attribut n’est retenu pour la Dim. 2 dans ce tableau.
3.7.6 Interprétation synthétique
L’espace sensoriel des chocolats est très largement structuré par une seule opposition forte, portée par la première dimension : d’un côté un profil lacté, sucré et fondant, de l’autre un profil amer, cacaoté et plus texturé. La carte des stimuli et celle des attributs convergent pour donner la même lecture d’ensemble. Les ellipses montrent en plus que tous les stimuli ne sont pas différenciés avec la même robustesse. Enfin, le test de Hotelling confirme que certaines proximités observées sur la carte ne correspondent pas à des différences clairement établies.
Ce qu’on retient de cet exemple : l’analyse ne montre pas seulement où se situent les stimuli dans l’espace sensoriel, mais aussi avec quel degré de robustesse on peut les distinguer.
3.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre précédent, cochez R code pour afficher le script correspondant à l’analyse. Pour ce chapitre, le code charge SensoMineR et FactoMineR, prépare les variables sélectionnées puis appelle panellipse() avec les réglages choisis dans l’interface.
Le script généré contient aussi un petit mécanisme qui empêche panellipse() d’ouvrir un périphérique graphique supplémentaire non pris en charge par le Rj Editor. Cette adaptation est gérée automatiquement : vous n’avez aucun réglage supplémentaire à effectuer.
Les objets produits permettent notamment de retrouver les valeurs propres, les tests de Hotelling et la description automatique des dimensions. Le code constitue ainsi un prolongement reproductible de l’analyse réalisée dans SEDA.
3.9 Conseils pratiques
- Commencez toujours avec X-axis = 1 et Y-axis = 2.
- Laissez Scale to unit variance coché dans la plupart des cas.
- Utilisez Center by subject presque systématiquement.
- N’activez Scale by subject que si vous avez une bonne raison de penser que les sujets utilisent l’échelle avec des amplitudes très différentes.
- Commencez avec 300 panels simulés ; augmentez à 500 ou plus pour une version finale plus stable.
- Réglez Descriptor selection threshold (%) entre 5 % et 20 % selon que vous cherchez une carte épurée ou plus exhaustive.
- N’interprétez jamais la carte des stimuli sans regarder la carte des attributs.
- Ne concluez pas à une différence sur la seule base du chevauchement ou de la séparation des ellipses.
- Consultez Hotelling Test pour compléter la lecture visuelle lorsque le chevauchement est ambigu.
- Si les deux premières dimensions résument peu de variance, explorez d’autres plans factoriels.
3.10 En résumé
Cette analyse produit une représentation multivariée des stimuli adaptée aux données de type QDA, en tenant compte de l’effet sujet dans la construction des profils sensoriels. Elle enrichit la carte factorielle classique par des ellipses obtenues par rééchantillonnage, ce qui permet d’évaluer la robustesse des positions observées. Elle montre donc non seulement où se situent les stimuli, mais aussi avec quel degré de confiance on peut les y situer.