7 Données de tri libre — Analyse des catégorisations
7.1 Introduction
Cette analyse est conçue pour les données de tri libre (sorting task), dans lesquelles chaque sujet regroupe des stimuli en catégories selon sa propre perception. Elle permet d’obtenir une représentation multivariée des stimuli à partir des catégorisations fournies par les sujets, puis, si besoin, une classification automatique des stimuli en groupes. Lorsque les groupes ont été verbalisés, la fonction fournit aussi une description textuelle des stimuli à partir des mots utilisés pour nommer ces groupes.
Pourquoi ne pas utiliser une alternative standard ?
Une approche classique consiste à transformer les tris en matrice de similarité entre stimuli, puis à appliquer une méthode de projection comme une MDS. Cette stratégie est utile, mais elle efface une partie de l’information individuelle portée par chaque sujet. Ici, la fonction analyse directement les colonnes de Active Subjects comme des variables qualitatives et applique une Analyse des Correspondances Multiples (ACM), ce qui préserve davantage la structure des réponses individuelles et permet de représenter simultanément stimuli et catégories dans un même espace.
7.2 Comprendre ce qui se passe “sous le capot”
7.2.1 Les stimuli sont les individus de l’analyse
La fonction lit les colonnes placées dans Active Subjects comme des variables catégorielles. Chaque ligne correspond à un stimulus, et chaque colonne indique dans quel groupe un sujet a placé ce stimulus. Si Stimuli Labels est renseigné, cette variable sert à nommer les stimuli dans les sorties ; sinon, la fonction utilise les numéros de ligne.
7.2.2 Une ACM sur les catégorisations fournies par les sujets
Le cœur de la fonction est une ACM appliquée aux colonnes de Active Subjects. Dans ce cadre, deux stimuli sont proches lorsque leurs profils de tri sont similaires à travers les sujets actifs. Les colonnes placées dans Supplementary Subjects, si elles existent, sont projetées comme variables qualitatives supplémentaires : elles apparaissent dans l’espace factoriel, mais ne participent pas à la construction des axes.
7.2.3 Le rôle de Ventilation level (%)
Le paramètre Ventilation level (%) est transmis à l’ACM de FactoMineR. Les catégories dont la fréquence est inférieure au seuil sont ventilées avant l’ACM : les stimuli concernés sont réaffectés aléatoirement à d’autres catégories observées de la même variable. Cela limite l’influence des catégories extrêmement rares, mais peut introduire une légère variabilité entre exécutions. La valeur par défaut est 5 % ; une valeur de 0 % désactive cette ventilation.
7.2.4 Description textuelle des stimuli
La fonction construit un tableau de correspondance stimuli × mots à partir des libellés de groupes, puis applique une procédure de description des fréquences. Cette partie sert à identifier, pour chaque stimulus, les mots les plus caractéristiques parmi les libellés utilisés par les sujets. Elle devient particulièrement utile lorsque les groupes ont été nommés avec des termes sensoriels interprétables.
7.2.5 Description automatique des dimensions et clustering
Une fois l’ACM calculée, la fonction produit une description automatique des dimensions selon Significance threshold (%) et Number of dimensions. Si vous activez Representation of the clusters, la fonction applique HCPC aux coordonnées des stimuli sur les composantes retenues. Par défaut, la classification repose sur les 5 premières composantes, et Number of clusters = -1 laisse HCPC choisir automatiquement le nombre de groupes. Les pourcentages affichés sur la carte HCPC se rapportent à cet espace retenu et peuvent donc différer de ceux de la carte ACM complète.
7.3 Structure des données attendues
Les données doivent contenir :
- une colonne facultative pour Stimuli Labels ;
- au moins deux colonnes catégorielles dans Subjects ;
- éventuellement des colonnes catégorielles dans Supplementary Subjects.
Chaque ligne correspond à un stimulus. Ce point est important : contrairement à d’autres analyses, ici une ligne ne correspond pas à une réponse individuelle, mais à un stimulus décrit par les catégorisations données par plusieurs sujets.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- Stimuli Labels est catégorielle si vous l’utilisez ;
- toutes les colonnes de Active Subjects sont catégorielles (facteurs) ;
- toutes les colonnes de Supplementary Subjects sont catégorielles ;
- vous avez bien placé au moins deux variables dans Active Subjects.
7.4 Guide de l’interface
L’analyse apparaît dans SEDA > Free Perception > Analysis of Sorting Data. L’interface comprend trois zones de dépôt de variables, la section Instructions and R Code, puis les sections Random Assignment for Rare Categories, Graphic Options, Numerical Indicators et Clustering.
7.4.1 Variables à renseigner
7.4.1.1 Stimuli Labels
Rôle : fournit les noms des stimuli dans les sorties. Impact sur le calcul : ne modifie pas l’ACM, mais détermine les étiquettes affichées dans les graphiques et les noms associés aux coordonnées sauvegardées. Conseil pratique : utilisez des libellés courts et uniques ; sinon, la lecture des cartes devient difficile.
7.4.1.2 Active Subjects
Rôle : regroupe les variables de tri qui construisent l’espace factoriel, une par sujet. Impact sur le calcul : ce sont les variables actives de l’ACM. La classification utilise ensuite les coordonnées des stimuli issues de cette ACM. Au moins deux variables sont requises. Conseil pratique : vérifiez que chaque colonne est bien catégorielle dans jamovi.
7.4.1.3 Supplementary Subjects
Rôle : regroupe des variables projetées comme qualitatives supplémentaires. Impact sur le calcul : n’influencent pas la construction des axes, mais leur position dans l’espace peut aider à l’interprétation. Conseil pratique : utile pour projeter un second groupe de sujets sans modifier le résultat principal.
7.4.2 Instructions and R Code
7.4.2.1 Read me before running
Rôle : affiche une aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez-la cochée lors des premières utilisations. Elle est activée par défaut.
7.4.2.2 R code
Rôle : affiche le script R correspondant à l’analyse courante. Impact sur le calcul : aucun. Conseil pratique : cochez cette option si vous souhaitez reproduire l’analyse dans le Rj Editor ; elle est désactivée par défaut.
7.4.3 Random Assignment for Rare Categories : Ventilation level (%)
Rôle : fixe le seuil en dessous duquel une catégorie est ventilée avant l’ACM. Impact sur le calcul : les stimuli appartenant à une catégorie rare sont réaffectés aléatoirement à d’autres catégories observées de la même variable. La valeur par défaut est 5 %. Conseil pratique : laissez 5 % pour un premier essai ; utilisez 0 % si vous souhaitez conserver les catégories rares sans ventilation.
7.5 Procédure pas à pas
- Ouvrez votre jeu de données dans jamovi.
- Dans l’onglet Données, vérifiez que toutes les colonnes de Active Subjects sont bien catégorielles et que vous en avez au moins deux.
- Vérifiez que Stimuli Labels est catégorielle si vous l’utilisez.
- Ouvrez SEDA > Free Perception > Analysis of Sorting Data.
- Placez la variable de noms des stimuli dans Stimuli Labels.
- Placez les variables de tri qui construisent l’espace dans Active Subjects.
- Placez, si besoin, d’autres variables de tri dans Supplementary Subjects.
- Laissez Ventilation level (%) = 5, X-axis = 1, Y-axis = 2, les deux Significance threshold (%) = 5, Number of dimensions = 2 et Number of components = 5 pour un premier essai.
- Si les sujets ont verbalisé leurs groupes, commencez par Words Associated with the Stimuli.
- Lisez ensuite Eigenvalue Decomposition, Representation of the Stimuli, Representation of the Subjects et Representation of the Sorting Categories.
- Consultez Automatic Description of the Dimensions pour identifier les sujets et catégories associés aux axes.
- Activez Representation of the clusters si vous souhaitez une classification HCPC.
7.6 Interprétation des résultats
7.6.1 Description of the Stimuli from Sorting Labels — Words Associated with the Stimuli
Cette table décrit chaque stimulus à partir des mots utilisés dans les libellés de groupes. Elle n’est vraiment informative que si les groupes ont été nommés avec des mots interprétables.
| Élément | Signification |
|---|---|
| Première colonne | Stimulus concerné |
| Word | Mot caractéristique |
| Internal % | Pourcentage du mot pour ce stimulus |
| Global % | Pourcentage global du mot |
| Internal frequency | Fréquence du mot pour ce stimulus |
| Global frequency | Fréquence globale du mot |
| p | P-value du test |
| V-test | Intensité standardisée de l’association |
- Un mot avec un Internal % nettement supérieur à Global % caractérise davantage ce stimulus.
- Une p-value faible indique une association plus nette.
- Un V-test positif indique une sur-représentation du mot pour ce stimulus ; un V-test négatif une sous-représentation.
7.6.2 Representation of the Stimuli — carte des stimuli
C’est le résultat central de la fonction. Elle représente les stimuli dans l’espace factoriel de l’ACM.
| Élément | Signification |
|---|---|
| Deux stimuli proches | Leurs profils de tri sont similaires à travers les sujets actifs |
| Deux stimuli éloignés | Leurs profils de tri sont plus différents |
| Groupe compact de stimuli | Famille de stimuli présentant des profils de tri proches |
Le pourcentage affiché sur chaque axe indique la part d’inertie de l’ACM expliquée par cette dimension. Sans verbalisation ou information externe, les axes décrivent des contrastes de tri mais ne reçoivent pas automatiquement une signification sensorielle.
7.6.3 Representation of the Sorting Categories — carte des catégories
La figure Figure 7.1, obtenue avec le jeu de données perfumes_sorting, montre la représentation des catégories de tri dans le plan factoriel.
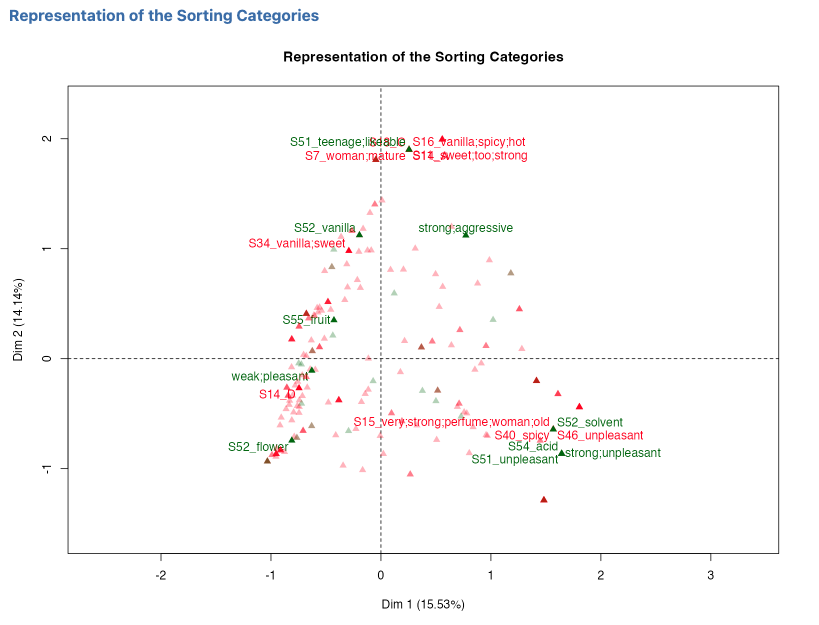
Cette carte représente les catégories propres à chaque sujet. Leur direction par rapport à l’origine aide à caractériser les côtés des axes ; la distance directe entre une catégorie et un stimulus ne doit pas être interprétée comme une mesure ordinaire de similarité. Les options Active categories, Supplementary categories et Selection of categories contrôlent ce qui est affiché.
Point de vigilance : avec de nombreux sujets, cette carte peut devenir très chargée. La valeur par défaut cos2 10 aide justement à ne conserver qu’un sous-ensemble plus lisible des catégories.
7.6.4 Representation of the Subjects — carte des sujets
Cette carte représente les sujets comme variables qualitatives de l’ACM. Elle montre quels sujets sont associés aux dimensions communes. La table Subjects Associated with the Dimensions fournit cette association sous forme de R² et de p-values ; la carte ne doit pas être lue comme un indice direct de consensus entre sujets.
7.6.5 Eigenvalue Decomposition — tableau des valeurs propres
| Élément | Signification |
|---|---|
| Dim. | Numéro de la dimension |
| Eigenvalue | Valeur propre |
| % of variance | Part expliquée par la dimension |
| Cumulative % | Part cumulée expliquée |
Si les deux premières dimensions expliquent une part importante de la variance, le plan 1/2 résume bien la structure des tris. Dans le cas contraire, explorez d’autres plans factoriels.
7.6.6 Automatic Description of the Dimensions
Cette sortie comporte les tables Subjects Associated with the Dimensions et Sorting Categories Associated with the Dimensions. Elle identifie les sujets et catégories associés à chaque dimension selon Significance threshold (%) et Number of dimensions. Elle décrit donc les contrastes de tri ; une signification sensorielle ne peut être attribuée aux axes que si les libellés de groupes ou d’autres informations externes la soutiennent.
7.6.7 Representation of the Stimuli According to Clusters (disponible si “Representation of the clusters” est activé)
Ce graphique projette les groupes obtenus par HCPC. La classification utilise les premières composantes définies par Number of components, et pas seulement les deux axes affichés. Les pourcentages portés par la carte HCPC sont donc calculés relativement à cet espace retenu et peuvent être plus élevés que ceux de la carte ACM complète.
| Élément | Signification |
|---|---|
| Stimuli dans un même cluster | Profils de tri proches dans l’espace retenu |
| Clusters bien séparés | Familles de stimuli plus différenciées |
7.6.8 Tableaux numériques (optionnels)
Les tableaux de coordonnées, contributions et cosinus pour les stimuli et les sujets n’apparaissent que si vous cochez les options correspondantes dans Numerical Indicators. Ils fournissent les valeurs précises pour compléter l’interprétation visuelle.
7.7 Exemple : le jeu de données perfumes_sorting
Le jeu de données perfumes_sorting porte sur 12 parfums regroupés par 58 sujets lors d’une tâche de tri libre. Il sert à illustrer les sorties de la fonction. Certains groupes ont en plus été verbalisés, ce qui permet à la fonction de produire à la fois une représentation factorielle des parfums et une description textuelle des profils. Les valeurs numériques et les graphiques commentés ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
7.7.1 Paramètres de l’exemple
Pour reproduire cet exemple, voici les valeurs à utiliser.
| Option | Valeur |
|---|---|
| Stimuli Labels | Product |
| Active Subjects | S1 à S50 |
| Supplementary Subjects | S51 à S58 |
| R code | coché |
| Ventilation level (%) | 5 |
| X-axis / Y-axis | 1 / 2 |
| Significance threshold (%) (description des dimensions) | 5 |
| Number of dimensions | 2 |
| Significance threshold (%) (description des libellés) | 5 |
| Number of components | 5 |
| Representation of the clusters | coché pour visualiser la classification |
| Number of clusters | -1 |
Figure 7.2 présente la configuration utilisée pour l’exemple de tri libre.
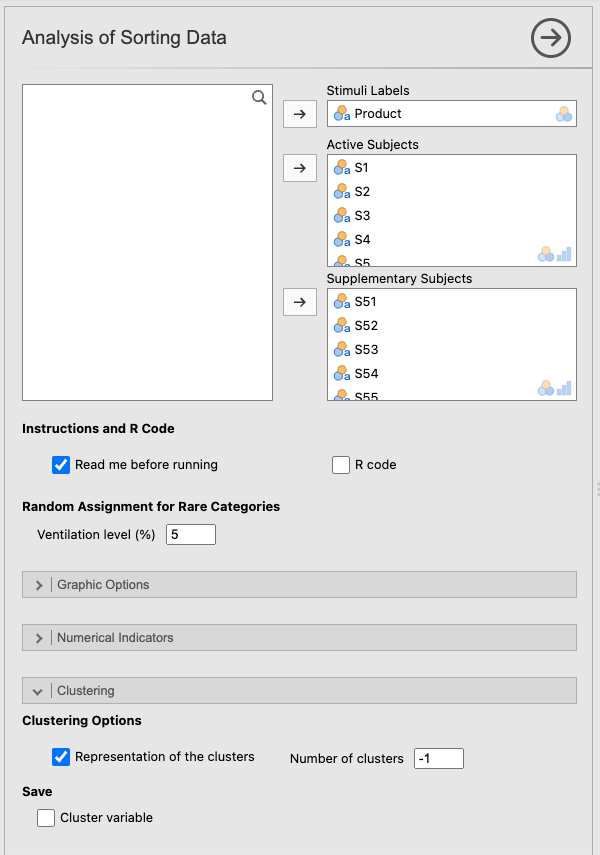
Remarque de reproductibilité : avec Ventilation level (%) = 5, les catégories rares peuvent être ventilées par réaffectation aléatoire avant l’ACM. De petites différences numériques peuvent donc apparaître d’une exécution à l’autre. Utilisez Ventilation level (%) = 0 uniquement si une reproductibilité exacte de la solution factorielle entre exécutions est nécessaire, en gardant à l’esprit que cela modifie l’analyse.
7.7.2 Analyse du tableau Description of the Stimuli
La table montre que plusieurs parfums possèdent des profils lexicaux très marqués. Quelques lectures particulièrement nettes, avec les valeurs réelles issues de l’analyse :
Aromatics Elixir est fortement associé à strong (valeur test 4.08, p < .001 ; 14.16 % des occurrences internes contre 4.65 % globalement), ammonia (valeur test 2.26) et spicy (2.18). Il est à l’inverse nettement sous-représenté par fruit (valeur test -2.63), flower (-2.40) et sweet (-2.10) : c’est le parfum le plus intense et le moins floral ou sucré du panel.
Chanel N5 ressort avec soap (valeur test 3.72, p < .001 ; 7.69 % contre 1.61 % globalement), deodorant (2.06) et unpleasant (1.99), tout en étant sous-représenté par fruit (-2.47) et flower (-2.21).
Lolita Lempicka est caractérisé par sweet (valeur test 3.94, p < .001 ; 14.55 % contre 4.98 % globalement) et vanilla (2.09), mais sous-représenté par flower (-2.34).
Pleasures est le parfum le plus associé à flower (valeur test 3.46, p < .001 ; 15.00 % contre 5.70 % globalement) et fresh (2.05), et nettement opposé à strong (-2.46).
Shalimar est caractérisé par old (valeur test 2.67, p = 0.008) et sun (2.40), et sous-représenté par flower (-2.42).
Angel est associé à vanilla (2.23), heady (1.99) et too (1.99), mais sous-représenté par fresh (-2.03) et flower (-2.19).
7.7.3 Analyse du graphique Representation of the Stimuli
Figure 7.3 montre la représentation des stimuli dans le plan factoriel de l’ACM.
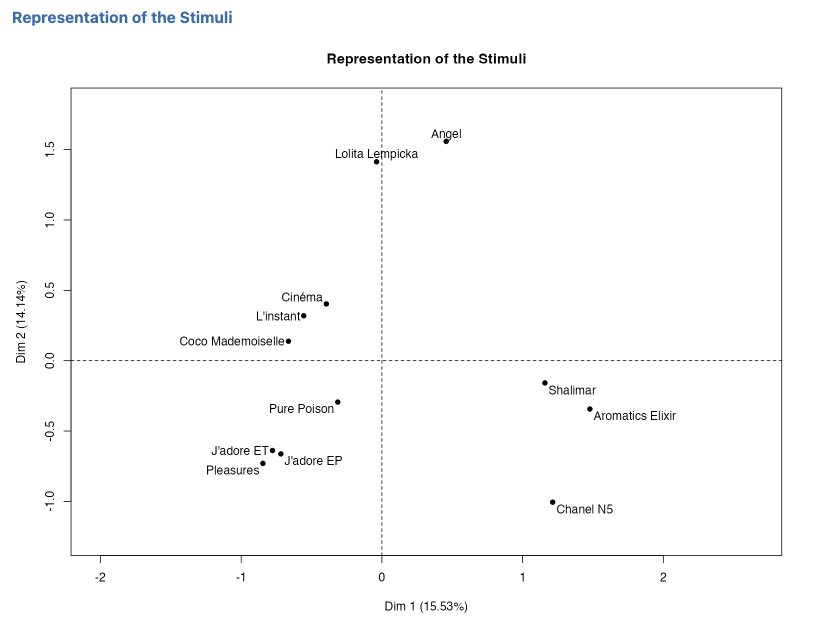
La carte fait apparaître une structure perceptive lisible sur le plan Dim. 1 (15.53 %) / Dim. 2 (14.14 %). À droite du plan, Shalimar, Aromatics Elixir et Chanel N5 forment un groupe — confirmant leur profil fort, épicé et peu floral. À gauche et en bas, J’adore ET, J’adore EP et Pleasures se regroupent autour d’un profil floral et frais. En haut, Angel et Lolita Lempicka occupent une position nettement distincte sur la seconde dimension — profil vanillé et sucré. Cinéma, L’instant et Coco Mademoiselle forment une zone intermédiaire centrale-gauche, avec des profils plus difficiles à nommer sans la description textuelle.
7.7.4 Analyse du tableau Eigenvalue Decomposition
Les deux premières dimensions expliquent 29.67 % de la variance totale (15.53 % + 14.14 %). C’est nettement moins concentré que dans une ACP classique : en tri libre, les sujets ont des façons très différentes de structurer l’espace, ce qui répartit l’information sur de nombreuses dimensions. Le plan 1/2 est une synthèse utile mais partielle — ce que confirment les dimensions suivantes (Dim. 3 : 11.03 %, Dim. 4 : 9.97 %, etc.).
7.7.5 Analyse du tableau Automatic Description of the Dimensions
Sur Dim. 1, les catégories les plus fortement associées au côté positif (droite, parfums forts) sont solvent (S52, estimé 1.31), unpleasant (S46, 1.27), spicy (S40, 1.24), very;strong;perfume;woman;old (S15, 1.32), soap;ancient (S48, 1.26) et acid (S54, 1.22). Le côté négatif est associé à flower;fresh (S43, -0.60), fresh;light (S23, -0.81) et flower (S47, -0.68). La Dim. 1 oppose donc clairement des parfums forts, épicés, acides ou désagréables à des parfums frais et floraux.
Sur Dim. 2, le côté positif est dominé par vanilla;spicy;hot (S16, 1.51), woman;mature (S7, 1.55), sweet;too;strong (S11, 1.43), teenage;likeable (S51, 1.54) et vanilla;sweet (S34, 1.05). Le côté négatif inclut soap (S12, -1.03) et fresh (S10, -0.50). La Dim. 2 oppose donc des parfums vanillés, sucrés, enveloppants à des profils plus frais ou savonneux.
7.7.6 Analyse du graphique Representation of the Stimuli According to Clusters
Figure 7.4 montre la représentation des stimuli selon les clusters.
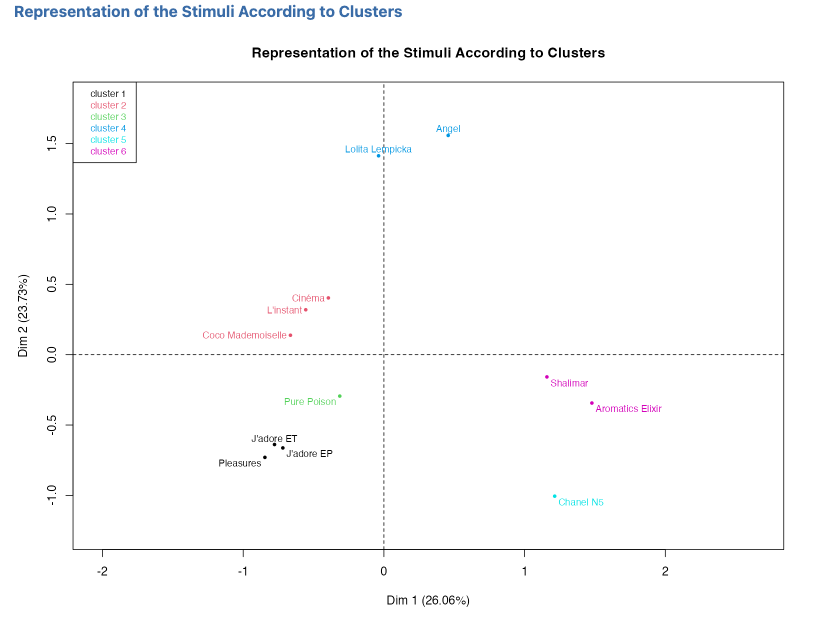
Avec Number of components = 5, HCPC travaille sur les cinq premières dimensions de l’ACM, qui cumulent 59.59 % de l’inertie. La carte de classification affiche donc 26.06 % sur Dim. 1 et 23.73 % sur Dim. 2, au lieu de 15.53 % et 14.14 % sur la carte ACM : les pourcentages sont renormalisés dans l’espace à cinq dimensions effectivement utilisé pour la classification.
Avec Number of clusters = -1, la classification automatique retient six clusters. Les qualificatifs entre parenthèses ci-dessous reposent sur la description textuelle et la description des dimensions, et non sur la classification seule :
- un cluster regroupant J’adore ET, J’adore EP et Pleasures (floral, frais) ;
- un cluster regroupant Coco Mademoiselle, L’instant et Cinéma (profils intermédiaires) ;
- un cluster réduit à Pure Poison (profil singulier) ;
- un cluster regroupant Angel et Lolita Lempicka (vanillé, sucré) ;
- un cluster réduit à Chanel N5 (savonneux, désagréable) ;
- un cluster regroupant Shalimar et Aromatics Elixir (fort, épicé, ancien).
7.7.7 Interprétation synthétique
Cet exemple montre bien l’intérêt de la fonction. On n’obtient pas seulement une carte de proximité entre parfums : on voit aussi quels mots les sujets associent à chaque parfum, quelles oppositions structurent l’espace, et quels groupes de parfums émergent de la classification. Le croisement entre la table de description, la carte factorielle et la classification permet de nommer les familles avec plus de précision qu’avec la carte seule.
Ce qu’on retient de cet exemple : l’analyse de tri libre permet de relier la structure factorielle des catégorisations, leur interprétation verbale et la formation de familles cohérentes de stimuli.
7.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code pour afficher le script correspondant à l’analyse. Le jeu de données ouvert dans jamovi est disponible sous le nom data.
Pour le tri libre, le script charge FactoMineR, construit le tableau des sujets actifs et supplémentaires, puis exécute MCA() avec les sujets supplémentaires dans quali.sup et le seuil Ventilation level (%) dans level.ventil. Lorsque les groupes comportent des libellés verbaux, il construit aussi les données textuelles, utilise textual() puis descfreq(), et reproduit les valeurs propres, les cartes avec plot.MCA() et la description automatique avec dimdesc().
Si une classification est demandée, le script extrait exactement les premières coordonnées définies par Number of components, les transmet à HCPC() puis affiche la carte avec plot.HCPC(). Les pourcentages de cette carte décrivent donc l’espace retenu pour la classification ; dans l’exemple, cinq dimensions cumulent 59.59 % de l’inertie, ce qui conduit à 26.06 % et 23.73 % sur la carte HCPC.
7.9 Conseils pratiques
- Vérifiez toujours que toutes les colonnes de Active Subjects sont bien catégorielles avant de lancer l’analyse.
- Utilisez Stimuli Labels presque systématiquement pour obtenir des cartes lisibles.
- Commencez avec Ventilation level (%) = 5.
- Si la carte des catégories est trop chargée, gardez Selection of categories = cos2 10 et décochez Active categories si nécessaire.
- Laissez Number of clusters = -1 pour une détermination automatique au départ.
- Gardez Number of components = 5 pour un premier clustering.
- Si les deux premières dimensions expliquent peu de variance, explorez d’autres plans factoriels.
- Activez Coordinates et Cluster variable si vous souhaitez réutiliser les résultats dans d’autres analyses jamovi.
7.10 En résumé
Cette analyse transforme des données de tri libre en une lecture à la fois factorielle, textuelle et typologique des stimuli. Elle combine une ACM sur les catégorisations fournies par les sujets, une description des stimuli à partir des libellés, puis, si souhaité, une classification automatique des stimuli. Son intérêt principal est de préserver l’information individuelle des sujets tout en construisant une vue consensuelle et directement interprétable de l’espace perceptif des stimuli.