4 Données CATA — Analyse par termes cochés
4.1 Introduction
Cette analyse est conçue pour les données de type CATA (Check-All-That-Apply), c’est-à-dire lorsque des sujets cochent, parmi une liste prédéfinie, tous les termes qu’ils jugent appropriés pour décrire un stimulus. Elle permet de répondre à deux questions complémentaires : quels termes caractérisent chaque stimulus et comment les stimuli s’organisent globalement selon leurs profils CATA. La fonction produit un tableau de contingence, une description des stimuli selon les termes CATA, ainsi qu’une analyse des correspondances suivie d’une classification des stimuli, automatique par défaut.
Pourquoi ne pas utiliser une alternative standard ?
Les données CATA sont, à l’origine, des réponses binaires par sujet et par terme. Une comparaison de moyennes classique n’est donc pas l’outil le plus adapté pour représenter la structure globale de ces données. La fonction commence par agréger les réponses dans un tableau de contingence stimuli × termes, puis applique des méthodes adaptées à cette structure : description des fréquences, analyse des correspondances et, si possible, classification.
4.2 Comprendre ce qui se passe “sous le capot”
4.2.1 Construction du tableau de contingence
La première étape consiste à regrouper les réponses par stimulus. La fonction additionne les colonnes placées dans le champ CATA pour chaque modalité de Stimulus Effect. On obtient ainsi un tableau où les lignes sont les stimuli, les colonnes sont les termes CATA, et chaque cellule indique combien de fois un terme a été coché pour un stimulus donné. C’est ce tableau qui sert de base à toutes les sorties suivantes.
Remarque : il est possible de copier ce tableau dans un fichier de type tableur.
4.2.2 Description des stimuli par les termes
À partir de ce tableau de contingence, la fonction applique une procédure de description des fréquences dépendante de la valeur du seuil défini dans Significance threshold (%). Pour chaque stimulus, il repère les termes qui sont significativement plus ou moins fréquents que dans l’ensemble du tableau. Cette logique est proche de celle d’une description statistique des profils, mais adaptée ici à des fréquences de coche plutôt qu’à des notes continues. Le même seuil s’applique ensuite à la description des clusters.
Un terme absent du tableau de description n’est pas significativement associé à un stimulus au seuil choisi. Cela peut signifier qu’il est coché de façon assez homogène entre les stimuli.
4.2.3 Analyse des correspondances
Si au moins trois variables sont placées dans le champ CATA, la fonction réalise une analyse des correspondances sur le tableau de contingence. Cette méthode représente simultanément les stimuli et les termes dans un même espace factoriel. Deux stimuli proches sur la carte ont tendance à partager des profils CATA proches ; deux termes proches ont tendance à être cochés pour des stimuli similaires. Les axes résument les grandes oppositions de profils entre stimuli et termes.
4.2.4 Classification des stimuli
Lorsque l’analyse des correspondances a été calculée, la fonction lance une classification hiérarchique sur composantes principales (HCPC). Par défaut, Number of clusters = -1 laisse FactoMineR déterminer automatiquement le nombre de groupes, mais l’utilisateur peut aussi imposer un nombre de clusters. La classification utilise les premières dimensions de l’analyse des correspondances définies par Number of dimensions for clustering ; ce réglage est distinct du choix du plan affiché avec X-axis et Y-axis. Les pourcentages affichés sur la carte HCPC sont exprimés relativement à l’inertie de cet espace de classification retenu et peuvent donc différer de ceux de la carte AC complète.
La fonction produit ensuite une carte des stimuli selon leurs clusters et une description des clusters avec le même seuil de significativité que pour la description des stimuli.
4.2.5 Conditions minimales pour lancer l’analyse
SEDA exige au moins trois variables CATA. Avec moins de trois attributs, l’analyse s’arrête. Pour construire une carte d’analyse des correspondances en deux dimensions, le tableau agrégé doit également contenir au moins trois stimuli et trois attributs CATA informatifs.
Les variables CATA doivent être des indicateurs complets codés 0/1 : 0 signifie que le terme n’a pas été coché et 1 qu’il a été coché. Les valeurs manquantes ne sont pas interprétées comme des réponses non cochées et doivent être résolues avant l’analyse.
4.3 Structure des données attendues
Les données doivent contenir :
- une colonne catégorielle identifiant les stimuli ;
- au moins trois colonnes CATA codées en 0/1.
Chaque ligne correspond à l’évaluation d’un stimulus par un sujet. Si 40 sujets évaluent 6 stimuli, le fichier contient en général une ligne par sujet et par stimulus, avec une colonne par terme CATA.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- la variable destinée à Stimulus Effect est bien catégorielle ;
- les variables destinées à CATA sont numériques et ne contiennent que
0et1; - aucune réponse CATA n’est manquante : une valeur manquante n’est pas assimilée à
0; - au moins trois termes CATA sont sélectionnés ;
- au moins trois stimuli sont effectivement observés pour obtenir le plan factoriel en deux dimensions.
4.4 Guide de l’interface
L’analyse apparaît dans le menu SEDA > Fixed List of Attributes > Analysis of CATA Data. L’interface comporte deux zones de dépôt de variables, un bloc Instructions and R Code, le champ Significance threshold (%), puis deux menus repliables : Graphic Options et Clustering.
4.4.1 Variables à renseigner
4.4.1.1 Stimulus Effect
Rôle : identifie les stimuli à comparer. Impact sur le calcul : cette variable définit les lignes du tableau de contingence et organise l’ensemble des sorties descriptives et graphiques. Conseil pratique : utilisez des libellés clairs, car ils apparaîtront dans les tableaux et dans les graphiques.
4.4.1.2 CATA
Rôle : regroupe les termes de la liste CATA. Impact sur le calcul : ces variables définissent les colonnes du tableau de contingence ; elles servent ensuite à la description des stimuli, à l’analyse des correspondances et à la classification. Conseil pratique : sélectionnez au moins trois variables CATA complètes codées en 0/1.
4.4.2 Instructions and R Code
4.4.2.1 Read me before running
Rôle : affiche une aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez-la cochée lors des premières utilisations. Elle est activée par défaut.
4.4.2.2 R code
Rôle : affiche le script R correspondant à l’analyse dans une sortie R Code. Impact sur le calcul : aucun. Conseil pratique : activez cette option pour reproduire l’analyse dans le Rj Editor ou poursuivre le travail dans R. Elle est désactivée par défaut.
4.4.3 Significance threshold (%)
Rôle : définit le seuil de la p-value utilisé pour sélectionner les termes caractéristiques des stimuli et des clusters. Impact sur le calcul : ce seuil agit sur les tables de description produites par descfreq, mais ne change pas la construction de l’analyse des correspondances ni de la classification. Conseil pratique : la valeur par défaut est 5 %.
4.4.4 Graphic Options
4.4.4.1 X-axis et Y-axis
Rôle : choisissent les deux dimensions de l’analyse des correspondances affichées sur les cartes. Impact sur le calcul : ils modifient le plan représenté, pas la structure de l’AC elle-même. Conseil pratique : commencez avec X-axis = 1 et Y-axis = 2, les valeurs par défaut.
4.4.5 Clustering
4.4.5.1 Number of dimensions for clustering
Rôle : fixe le nombre de premières dimensions de l’AC utilisées par HCPC. Impact sur le calcul : la classification peut donc utiliser plus d’information que le seul plan affiché. La valeur par défaut est 5 ; si moins de cinq dimensions sont disponibles, SEDA utilise toutes les dimensions disponibles. Conseil pratique : les axes choisis pour le graphique doivent être inclus parmi les dimensions utilisées pour la classification.
4.4.5.2 Number of clusters
Rôle : fixe le nombre de groupes de stimuli. Impact sur le calcul : avec la valeur par défaut -1, FactoMineR détermine automatiquement le nombre de clusters ; une valeur entière d’au moins 2 impose ce nombre de groupes. Le nombre demandé doit rester inférieur au nombre de stimuli. Conseil pratique : commencez avec -1, puis imposez un nombre de groupes seulement si vous avez une raison analytique de le faire.
4.5 Procédure pas à pas
- Ouvrez votre jeu de données dans jamovi.
- Dans l’onglet Données, vérifiez que la variable stimulus est catégorielle et que les variables CATA sont complètes et codées en 0/1.
- Ouvrez SEDA > Fixed List of Attributes > Analysis of CATA Data.
- Placez la variable stimulus dans Stimulus Effect.
- Placez au moins trois termes dans CATA.
- Laissez Significance threshold (%) à 5 % pour un premier essai.
- Conservez X-axis = 1 et Y-axis = 2.
- Laissez Number of dimensions for clustering = 5 et Number of clusters = -1 pour une première analyse.
- Commencez par lire Description of the Stimuli According to CATA.
- Consultez ensuite Representation of the Stimuli and the CATA en interprétant les stimuli et les termes par rapport aux axes.
- Lisez Representation of the Stimuli According to Clusters puis Description of the Clusters.
- Vérifiez enfin Aggregated CATA Table — Stimuli × CATA Frequency Table, qui contient les fréquences réellement utilisées dans les calculs.
- Si nécessaire, modifiez le plan factoriel ou les paramètres de classification, puis vérifiez que vos conclusions restent cohérentes.
4.6 Interprétation des résultats
4.6.1 Tableau de contingence
Ce premier tableau croise les stimuli en lignes et les termes CATA en colonnes. Chaque cellule indique le nombre de fois où un terme a été coché pour un stimulus donné.
| Élément | Signification |
|---|---|
| Valeur élevée dans une cellule | Le terme a souvent été coché pour ce stimulus |
| Ligne avec plusieurs valeurs élevées | Le stimulus est associé à plusieurs termes fréquents |
| Colonne élevée pour presque tous les stimuli | Terme fréquent, mais pas forcément discriminant |
Point de vigilance : un terme très fréquent n’est pas automatiquement un terme caractéristique. S’il est coché pour presque tous les stimuli, il contribuera peu à les distinguer.
4.6.2 Description of the Stimuli According to CATA
Ce tableau décrit chaque stimulus par les termes qui lui sont significativement associés, regroupés par stimulus. Les termes sont triés par V-test décroissante au sein de chaque groupe.
| Élément | Signification |
|---|---|
| (première colonne) | Stimulus concerné |
| CATA | Terme caractéristique |
| Intern % | Pourcentage d’utilisation du terme pour ce stimulus |
| Global % | Pourcentage global d’utilisation du terme |
| Intern frequency | Fréquence absolue du terme pour ce stimulus |
| Global frequency | Fréquence absolue totale du terme |
| p | P-value du test |
| V-test | Intensité standardisée de l’association |
- Une V-test positive indique que le terme est plus fréquemment coché pour ce stimulus que dans l’ensemble.
- Une V-test négative indique qu’il est moins fréquemment coché — et est tout aussi informatif.
- Une p-value faible indique une caractérisation plus nette.
Un stimulus absent de ce tableau n’est pas “sans profil” ; il se situe simplement proche de la moyenne de l’ensemble des stimuli au seuil choisi.
4.6.3 Representation of the Stimuli and the CATA (disponible avec au moins 3 termes)
Ce graphique n’est produit que si au moins trois termes sont placés dans CATA. Il représente simultanément les stimuli et les termes dans l’espace factoriel issu de l’analyse des correspondances.
- Deux stimuli proches ont des profils CATA proches.
- Stimuli et termes doivent être interprétés par rapport aux axes factoriels et aux oppositions qu’ils structurent ; une distance directe entre un stimulus et un terme ne se lit pas comme une distance euclidienne ordinaire.
- Le pourcentage affiché sur chaque axe indique la part de l’information totale capturée par cette dimension.
Cette carte donne une vue d’ensemble, mais elle ne remplace pas la table descriptive. Les deux doivent être lues ensemble.
4.6.4 Representation of the Stimuli According to Clusters (disponible avec au moins 3 termes)
Ce graphique représente les stimuli selon la partition issue de HCPC. Avec Number of clusters = -1, la partition est choisie automatiquement ; si un nombre de clusters est imposé, la carte reflète cette partition. La classification utilise les premières dimensions définies par Number of dimensions for clustering, tandis que X-axis et Y-axis déterminent le plan affiché. Les pourcentages de la carte HCPC se rapportent à l’espace de classification retenu, et non à l’inertie totale de l’AC.
- Des stimuli dans le même cluster ont des profils CATA proches.
- Des clusters éloignés correspondent à des familles de stimuli plus contrastées.
- Cette sortie aide à résumer la structure globale des stimuli.
4.6.5 Description of the Clusters (disponible avec au moins 3 termes)
Lorsque la classification est disponible, la fonction produit aussi une table décrivant chaque cluster par les termes qui lui sont significativement associés, avec la même logique que pour la description des stimuli.
| Élément | Signification |
|---|---|
| (première colonne) | Groupe de stimuli concerné |
| CATA | Terme caractéristique |
| Intern % | Pourcentage du terme dans le cluster |
| Global % | Pourcentage global du terme |
| Intern frequency | Fréquence absolue du terme dans le cluster |
| Global frequency | Fréquence absolue totale du terme |
| p | P-value |
| V-test | Intensité standardisée de l’association |
Cette table est particulièrement utile pour résumer les grandes familles de stimuli, au-delà du détail stimulus par stimulus.
4.7 Exemple : le jeu de données Giacalone_et_al_cata
Le jeu de données Giacalone_et_al_cata décrit 9 bières évaluées par 74 consommateurs sur 15 items CATA : il s’agit ici d’associer des bières à des occasions particulières. Il sert à illustrer les sorties de la fonction. Les valeurs numériques et les graphiques commentés ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
4.7.1 Paramètres de l’exemple
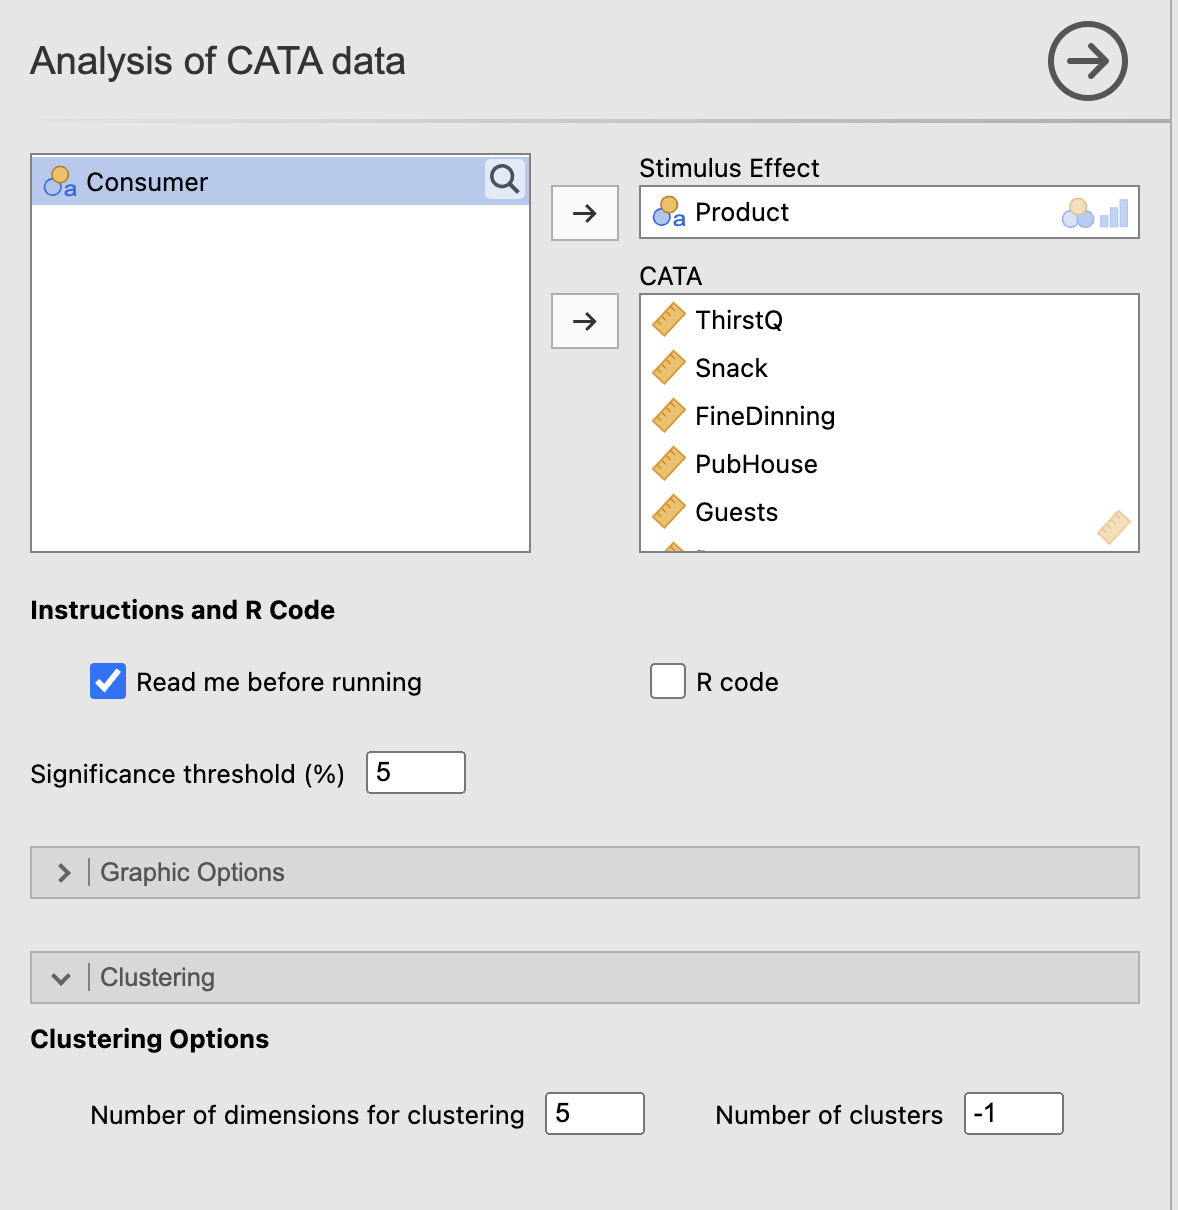
Pour reproduire cet exemple, voici les valeurs à utiliser.
| Option | Valeur |
|---|---|
| Stimulus Effect | Product |
| CATA | tous les items CATA de ThirstQ à Concert |
| Significance threshold (%) | 5 |
| X-axis / Y-axis | 1 / 2 |
| Number of dimensions for clustering | 5 |
| Number of clusters | -1 (automatic) |
Figure 4.1 présente la configuration utilisée pour l’exemple CATA.
4.7.2 Analyse du tableau Description of the Stimuli According to CATA
La table permet une lecture stimulus par stimulus avec les valeurs test et fréquences réelles.
GMA est significativement caractérisé par Rugby (V-test = 3.95, p < .001 ; 11.61 % contre 7.08 % globalement) et CampingFishing (2.73, p = 0.006). Il est à l’inverse sous-représenté par Gift (V-test = -4.36), Treat (-3.84) et FineDinning (-3.51) — tous très significatifs.
LR présente le profil le plus fortement marqué par Rugby de tout l’ensemble (V-test = 5.74, p < .001 ; 15.24 % contre 7.08 % globalement) et CampingFishing (2.83). Il est sous-représenté par Guests (-4.77), FineDinning (-3.91), Treat (-3.74) et Gift (-3.50).
SSA se distingue de tous les autres stimuli par l’intensité de ses associations positives : Gift (V-test = 6.43, p < .001 ; 13.41 % contre 4.21 % globalement), FineDinning (6.09), Treat (4.53), Achievement (3.71) et Guests (2.72). À l’inverse, il est fortement sous-représenté par Rugby (-4.29), ThirstQ (-3.63), Work (-3.01), CampingFishing (-2.88) et TV (-2.80). C’est le stimulus dont le profil s’écarte le plus nettement de la moyenne.
SC est davantage lié à Rugby (2.82) et ThirstQ (2.69), et sous-représenté par PubHouse (-2.67), Treat (-2.58) et Gift (-2.55).
HPW est davantage associé à Treat (V-test = 2.41) et Gift (2.21), et sous-représenté par Rugby (-3.29). PKB est davantage associé à Gift (2.60) et Treat (2.10) ; aucun terme négatif n’atteint le seuil de 5 % pour ce stimulus.
MBB ressort principalement par PubHouse (2.62) et se distingue négativement par ThirstQ (-2.35) et Rugby (-2.19).
STG n’est caractérisé que par Rugby en négatif (-2.75, p = 0.006).
4.7.3 Analyse du graphique Representation of the Stimuli and the CATA
Figure 4.2 montre la représentation factorielle utilisée dans cet exemple.
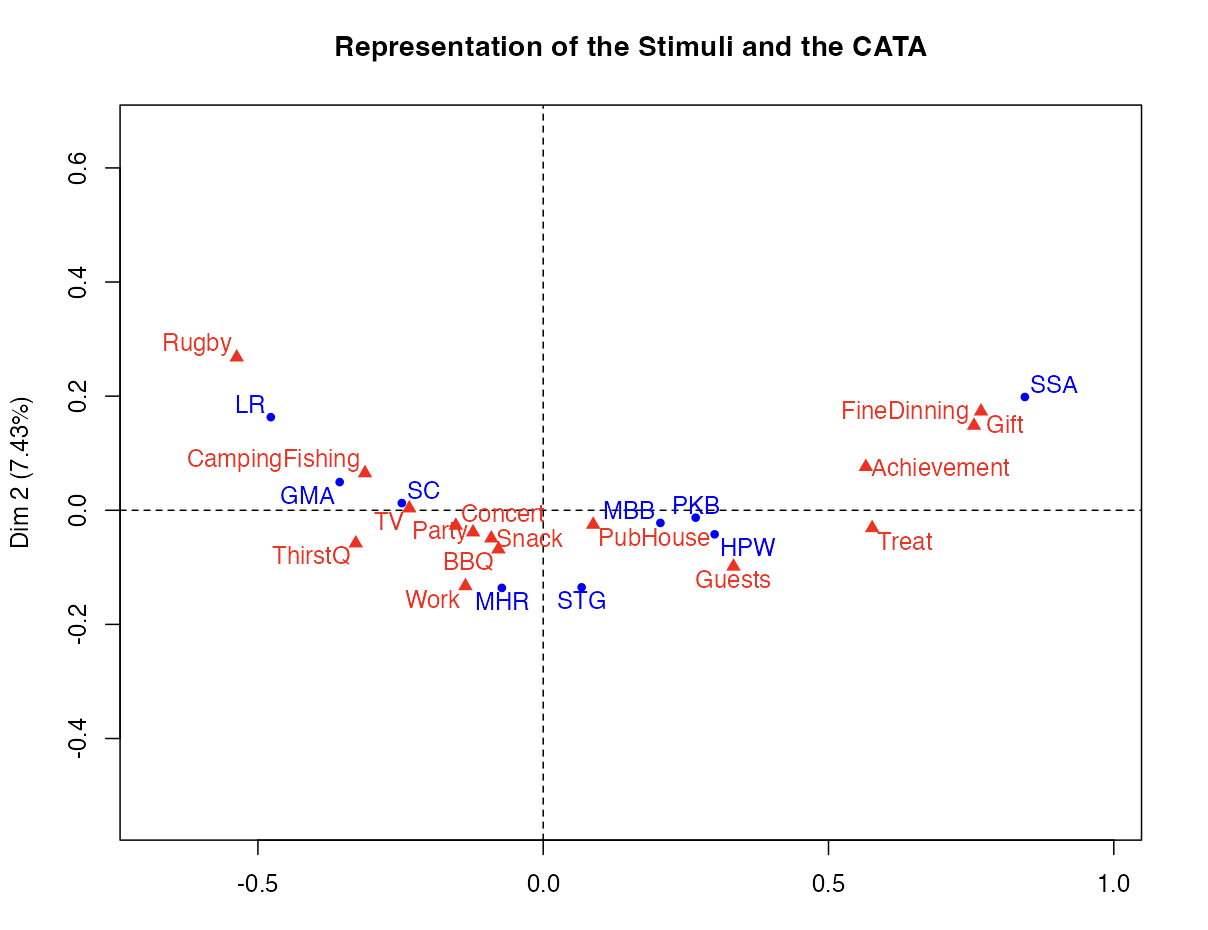
La première dimension explique 85.59 % de l’inertie — c’est une valeur remarquablement élevée, qui signifie que l’opposition principale entre les stimuli est très forte et très lisible sur l’axe horizontal. La seconde dimension n’explique que 7.43 %, mais affine des distinctions secondaires.
Sur la carte, SSA se situe très nettement à droite, isolé près de Gift, FineDinning et Achievement. À gauche se regroupent LR, GMA et SC, proches de Rugby et CampingFishing. MBB, HPW, PKB, MHR et STG occupent une position centrale ou légèrement à droite, entre les deux pôles. Sur la seconde dimension, LR se situe légèrement plus haut que GMA et SC, ce qui reflète sa plus forte association à Rugby.
4.7.4 Analyse du graphique Representation of the Stimuli According to Clusters et de la Description of the Clusters
Figure 4.3 montre la partition des stimuli retenue par la classification.
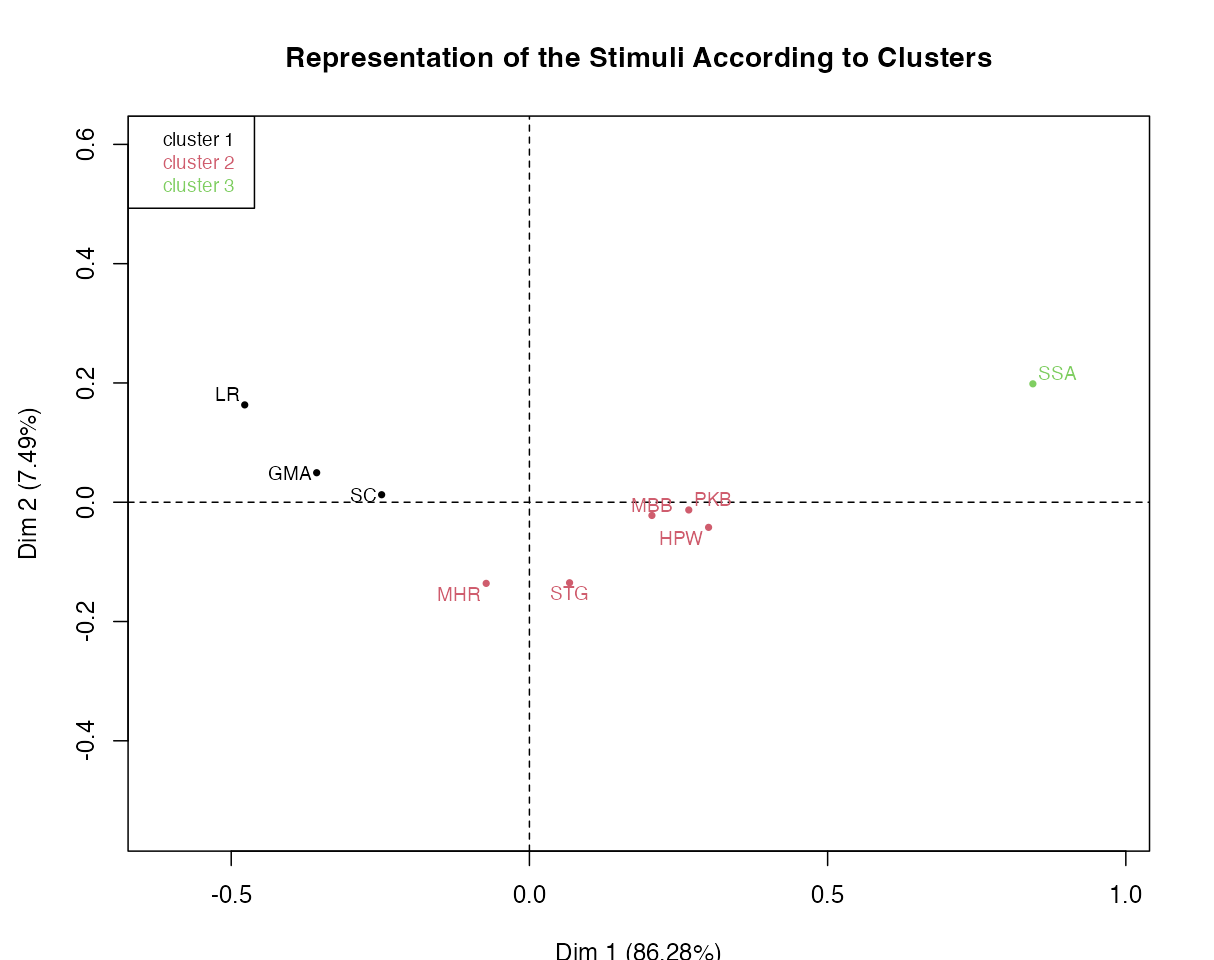
La classification automatique retient trois clusters :
Cluster 1 (noir) : LR, GMA et SC — caractérisé positivement par Rugby (V-test = 9.12, p < .001), CampingFishing (4.86), ThirstQ (3.81) et TV (3.01), et sous-représenté notamment par Gift (-6.97), Treat (-6.81), FineDinning (-6.21) et Guests (-4.67). Ce cluster correspond au pôle le plus fortement associé aux contextes sportifs et de plein air.
Cluster 2 (rouge) : MBB, HPW, PKB, MHR et STG — caractérisé positivement par Treat (V-test = 3.52), Guests (2.86), Gift (2.18), PubHouse (2.15) et Achievement (2.05), et sous-représenté par Rugby (-7.07), CampingFishing (-3.34) et ThirstQ (-2.02). Ce cluster rassemble des boissons davantage associées à des contextes sociaux ou de plaisir et moins aux contextes sportifs et de plein air.
Cluster 3 (vert) : SSA seul — caractérisé positivement par Gift (V-test = 6.43), FineDinning (6.09), Treat (4.53), Achievement (3.71) et Guests (2.72), et négativement par Rugby (-4.29), ThirstQ (-3.63), Work (-3.01), CampingFishing (-2.88), TV (-2.80) et Party (-2.39). Le profil de SSA est suffisamment singulier pour former à lui seul un cluster.
4.7.5 Interprétation synthétique
Cet exemple montre bien l’intérêt de la fonction. On ne se contente pas de savoir qu’un item est souvent coché : on voit pour quels stimuli il est vraiment caractéristique, comment les stimuli s’opposent globalement, et quels grands profils émergent de l’ensemble des réponses. Ici, l’opposition majeure — capturée à 85.59 % par la première dimension — oppose des boissons associées à des contextes sportifs et de plein air (Rugby, CampingFishing) à des boissons perçues comme plus sophistiquées (Gift, FineDinning, Treat). SSA constitue un cas à part, dont le profil est suffisamment singulier pour former un cluster seul.
Ce qu’on retient de cet exemple : l’analyse CATA permet de passer d’une simple fréquence de coches à une lecture structurée des oppositions entre stimuli et des grands profils qui s’en dégagent.
4.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code pour afficher le script correspondant à l’analyse. Le jeu de données ouvert dans jamovi est disponible sous le nom data.
Pour CATA, le script charge FactoMineR, agrège les indicateurs 0/1 par stimulus, puis utilise descfreq() pour la caractérisation, CA() pour l’analyse des correspondances et HCPC() pour la classification. Les paramètres X-axis / Y-axis, Number of dimensions for clustering et Number of clusters sont repris dans le code généré.
Le script utilise également les options graphiques adaptées au Rj Editor afin d’éviter l’ouverture d’un périphérique graphique externe. Aucun réglage supplémentaire n’est nécessaire.
4.9 Conseils pratiques
- Commencez avec Significance threshold (%) = 5 % ; augmentez à 10 % si les tables de description sont trop vides.
- Vérifiez toujours le tableau de contingence avant d’interpréter les graphiques.
- Il faut au moins trois termes CATA et trois stimuli observés pour construire le plan factoriel en deux dimensions.
- Une V-test négative est aussi informative qu’une V-test positive : elle signale qu’un terme est significativement moins coché pour un stimulus que pour les autres.
- Ne surinterpretez pas l’absence d’un stimulus dans la table descriptive : il peut simplement avoir un profil proche du profil moyen.
- La classification est automatique par défaut (
Number of clusters = -1), mais vous pouvez imposer un nombre de groupes ; jugez toujours sa pertinence en croisant la carte et la description des clusters. - Lisez la carte de correspondances conjointement avec le tableau de description : la carte donne une vue d’ensemble, le tableau fournit les détails.
- Les colonnes CATA doivent contenir uniquement
0et1et ne pas comporter de valeurs manquantes ; une valeur manquante n’est pas traitée comme une réponse non cochée.
4.10 En résumé
Cette analyse transforme des réponses CATA en une lecture structurée des profils CATA des stimuli. Elle combine un tableau de contingence, une description statistique des stimuli, une analyse des correspondances et une classification, automatique par défaut. Son intérêt principal est de passer d’une simple accumulation de coches à une vision à la fois descriptive, factorielle et typologique des stimuli.