8 Données hédoniques — Cartographie des préférences
8.1 Introduction
Cette analyse permet de construire une carte de préférences à partir de deux types d’informations : un espace de représentation à deux dimensions déjà calculé, et plusieurs Liking Variables correspondant à des notes d’appréciation. Elle sert à repérer quelles zones de cet espace sont associées à une préférence plus forte, et à représenter la proportion de consommateurs pour lesquels chaque région du plan est prédite comme favorable selon le seuil choisi. Dans SEDA, ce principe peut être utilisé aussi bien pour une cartographie externe des préférences (espace sensoriel) que pour une cartographie interne (espace hédonique), selon l’origine des deux axes utilisés. L’analyse peut également classer les consommateurs à partir de leurs profils hédoniques et produire une carte de préférence propre à chaque segment.
Pourquoi ne pas utiliser une alternative standard ?
Une moyenne de liking par produit permet de comparer des produits entre eux, mais elle ne permet pas de relier les préférences à un espace de représentation déjà construit. Ici, la fonction ajuste un modèle de préférence pour chaque variable de liking, puis combine ces modèles en une surface indiquant le % of consumers associé à chaque zone du plan. Cela apporte une lecture spatiale des préférences, plus informative qu’un simple tableau de moyennes.
8.2 Comprendre ce qui se passe “sous le capot”
8.2.1 La fonction ne construit pas elle-même l’espace de représentation
La fonction ne calcule pas les axes du plan : il attend que vous lui fournissiez une variable pour X-axis et une variable pour Y-axis. Le texte d’aide intégré précise explicitement le workflow recommandé : pour une carte externe, ces axes peuvent provenir d’une ACP sur les attributs sensoriels ; pour une carte interne, ils peuvent provenir d’une ACP sur les notes hédoniques. Dans les deux cas, les deux composantes doivent d’abord avoir été sauvegardées dans les données, puis sélectionnées dans ce module.
Comment récupérer les dimensions depuis le module MEDA
- Ouvrez le module MEDA (menu MEDA > PCA).
- Placez vos variables dans les champs appropriés : pour une carte externe, utilisez vos attributs sensoriels ; pour une carte interne, utilisez vos variables hédoniques.
- Déroulez la section Numerical Indicators, puis la sous-section Save.
- Dans le champ Number of components, indiquez 2 (ou plus si vous souhaitez explorer d’autres plans).
- Activez la sortie Coordinates : jamovi crée alors automatiquement deux nouvelles colonnes dans votre feuille de données, nommées par défaut Dim. 1 et Dim. 2, contenant les coordonnées de chaque stimulus sur les deux premières composantes.
- Revenez ensuite dans SEDA > Hedonic Data > Preference Mapping et placez Dim. 1 dans X-axis et Dim. 2 dans Y-axis.
Si votre jeu de données contient à la fois les attributs sensoriels, les notes hédoniques et les identifiants des stimuli dans le même fichier — ce qui est le cas du jeu senso_hedo_cocktail —, cette manipulation se fait entièrement dans jamovi sans export ni import intermédiaire.
8.2.2 Un modèle est ajusté pour chaque variable de liking
La fonction rassemble d’abord les deux coordonnées du plan et toutes les colonnes placées dans Liking Variables. Chaque colonne de liking représente ici un consommateur. Un modèle de préférence séparé est ajusté pour chacun d’eux. Le type de modèle dépend de Regression model :
- Quadratic (défaut) : effets linéaires, termes quadratiques et interaction entre les deux axes. Il faut au moins 7 stimuli pour un ajustement non saturé ; en pratique, davantage de produits est préférable.
- Vector : effets linéaires uniquement. Il faut au moins 4 stimuli.
- Circular : effets linéaires avec une courbure quadratique radiale commune. Il faut au moins 5 stimuli.
- Elliptical : effets linéaires et termes quadratiques séparés sur chaque axe, sans interaction. Il faut au moins 6 stimuli.
Une manière simple de les comprendre : Vector décrit une direction de préférence ; Quadratic autorise la surface la plus souple ; Circular et Elliptical représentent des optima locaux avec des contraintes de forme différentes. Si la géométrie des deux coordonnées ne permet pas d’estimer le modèle choisi, SEDA demande d’utiliser un modèle plus simple ou un espace produit plus riche.
8.2.3 Construction de la surface de préférence
Pour chaque consommateur, SEDA ajuste le modèle sur les produits observés puis prédit la préférence sur une grille régulière couvrant le plan X-axis / Y-axis. La surface prédite de chaque consommateur est ensuite standardisée : moyenne 0 et écart-type 1 sur la grille.
À chaque point de la grille, SEDA compte ensuite combien de consommateurs ont une valeur prédite standardisée supérieure à Preference threshold (SD). Ce nombre est converti en pourcentage et forme la surface % of consumers.
8.2.4 Preference threshold (SD)
Le seuil est exprimé en écarts-types de la surface prédite propre à chaque consommateur. Avec la valeur par défaut 0, une zone est considérée comme favorable pour un consommateur lorsque sa préférence prédite y est supérieure à son niveau prédit moyen sur la grille. Une valeur positive rend le critère plus sélectif ; une valeur négative l’élargit. Il s’agit d’un critère de préférence, pas d’un seuil de significativité statistique.
8.2.5 Ce que représente vraiment la carte finale
La carte finale ne montre pas directement les notes observées produit par produit. Elle montre une surface modélisée construite à partir des modèles individuels. Les zones indiquent la proportion de consommateurs pour lesquels chaque position du plan dépasse le seuil de préférence choisi. La légende % of consumers doit donc être lue comme un pourcentage de consommateurs dont la zone est prédite comme favorable, et non comme une note moyenne de liking.
8.2.6 Classification des consommateurs
Si Classification of consumers est activé, la classification est calculée séparément de la cartographie. Pour chaque consommateur, SEDA centre son profil de liking sur l’ensemble des stimuli, puis calcule les distances entre consommateurs et applique une classification hiérarchique de Ward (ward.D2). Le centrage enlève le niveau moyen propre à chaque consommateur : les groupes reflètent donc surtout des formes de préférence différentes entre produits, plutôt qu’une simple opposition entre consommateurs généreux et sévères dans leur notation.
Avec Number of clusters = -1, SEDA choisit automatiquement une coupure à partir du plus grand saut observé dans les niveaux supérieurs de la hiérarchie. Il est aussi possible d’imposer un nombre de groupes. Les cartes par cluster sont ensuite recalculées avec les consommateurs du groupe, tout en conservant exactement le même espace produit, le même modèle de régression et le même seuil de préférence que pour la carte globale.
8.3 Structure des données attendues
Les données doivent contenir :
- une colonne facultative pour Stimuli Labels ;
- une colonne numérique pour X-axis ;
- une colonne numérique pour Y-axis ;
- au moins deux colonnes numériques dans Liking Variables, une par consommateur.
Chaque ligne correspond à un stimulus. Les deux coordonnées représentent sa position dans l’espace 2D, et les colonnes de Liking Variables contiennent les notes des consommateurs pour ce même stimulus.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- X-axis et Y-axis sont deux variables numériques différentes et varient effectivement entre les stimuli ;
- toutes les colonnes de Liking Variables sont numériques et différentes des deux coordonnées ;
- vous avez sélectionné au moins deux variables de liking ;
- si vous utilisez Stimuli Labels, les libellés sont non manquants et uniques.
SEDA exige au minimum 4 stimuli, mais le minimum dépend ensuite du modèle choisi : 4 pour Vector, 5 pour Circular, 6 pour Elliptical et 7 pour Quadratic. La classification nécessite au moins 3 consommateurs. Des valeurs de liking manquantes isolées peuvent être imputées par SEDA à partir des effets produit et consommateur ; en revanche, un consommateur entièrement manquant, un stimulus sans aucun score hédonique ou un consommateur sans variation de liking est rejeté.
8.4 Guide de l’interface
L’analyse apparaît dans SEDA > Hedonic Data > Preference Mapping. L’interface comprend quatre zones de dépôt de variables, la section Instructions and R Code, les Preference Mapping Options, une section repliable Consumer Classification, puis Graphic Options.
8.4.1 Variables à renseigner
8.4.1.1 Stimuli Labels
Rôle : fournit les noms affichés pour les stimuli sur les cartes. Impact sur le calcul : ne change pas les modèles. Conseil pratique : utilisez des libellés courts, complets et uniques. Si aucune variable n’est fournie, SEDA utilise les numéros de ligne.
8.4.1.2 X-axis
Rôle : fournit la coordonnée horizontale des stimuli dans l’espace de représentation. Impact sur le calcul : entre directement dans les modèles de préférence. Conseil pratique : utilisez typiquement la première composante sauvegardée depuis une ACP réalisée dans MEDA.
8.4.1.3 Y-axis
Rôle : fournit la coordonnée verticale des stimuli. Impact sur le calcul : entre directement dans les modèles et doit provenir du même espace que X-axis. Conseil pratique : utilisez typiquement la seconde composante du même calcul.
8.4.1.4 Liking Variables
Rôle : regroupe les notes d’appréciation individuelles, une colonne par consommateur. Impact sur le calcul : un modèle est ajusté pour chaque colonne ; si la classification est activée, ces mêmes profils servent aussi à former les segments. Conseil pratique : utilisez les notes individuelles plutôt que des moyennes.
8.4.2 Instructions and R Code
8.4.2.1 Read me before running
Rôle : affiche l’aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez cette option cochée lors des premières utilisations.
8.4.2.2 R code
Rôle : affiche le script R correspondant aux réglages courants. Impact sur le calcul : aucun. Conseil pratique : cochez cette option pour reproduire l’analyse dans le Rj Editor.
8.4.3 Preference Mapping Options
8.4.3.1 Regression model
Rôle : choisit la forme de la surface ajustée pour chaque consommateur.
| Modèle | Structure | Minimum de stimuli |
|---|---|---|
| Quadratic (défaut) | Linéaire + quadratique + interaction | 7 |
| Vector | Linéaire | 4 |
| Circular | Linéaire + courbure radiale commune | 5 |
| Elliptical | Linéaire + quadratiques séparés, sans interaction | 6 |
Conseil pratique : commencez avec Quadratic lorsque le nombre et la géométrie des produits le permettent. Avec peu de produits, un modèle plus simple est souvent plus défendable.
8.4.3.2 Preference threshold (SD)
Rôle : fixe le niveau standardisé qu’une préférence prédite doit dépasser pour qu’une position soit comptée comme favorable pour un consommateur. Impact sur le calcul : modifie directement le pourcentage affiché sur la carte. Conseil pratique : commencez avec 0. Une valeur positive sélectionne des zones de préférence plus fortes ; une valeur négative élargit les zones favorables.
8.5 Procédure pas à pas
- Ouvrez votre fichier dans jamovi.
- Si vous ne disposez pas encore des coordonnées de l’espace 2D, construisez-les dans MEDA avec une PCA, puis sauvegardez au moins deux Coordinates.
- Vérifiez que X-axis, Y-axis et les Liking Variables sont numériques.
- Ouvrez SEDA > Hedonic Data > Preference Mapping.
- Placez la variable de noms des stimuli dans Stimuli Labels si vous en disposez.
- Placez deux coordonnées issues du même espace dans X-axis et Y-axis.
- Placez les notes individuelles des consommateurs dans Liking Variables.
- Commencez avec Regression model = Quadratic si vous avez au moins 7 produits et une géométrie suffisante ; sinon, choisissez un modèle plus simple.
- Laissez Preference threshold (SD) = 0 pour une première lecture.
- Lisez d’abord Overall Preference Map.
- Si vous souhaitez étudier l’hétérogénéité des préférences, activez Classification of consumers et commencez avec Number of clusters = -1.
- Lisez Consumer Cluster Sizes et Consumer Cluster Membership, puis le dendrogramme et les Preference Maps by Consumer Cluster.
- Cochez R code si vous souhaitez reproduire exactement ces réglages dans le Rj Editor.
8.6 Interprétation des résultats
8.6.1 Overall Preference Map — graphique principal
La carte représente l’espace fourni par X-axis et Y-axis, sur lequel est superposée la surface % of consumers.
| Élément | Signification |
|---|---|
| Zones vers Color for high preference areas | Régions favorables pour une forte proportion de consommateurs selon le seuil choisi |
| Zones vers Color for low preference areas | Régions favorables pour une faible proportion de consommateurs |
| Zones intermédiaires | Niveaux intermédiaires de consommateurs favorables |
| Courbes de niveau | Repèrent certains pourcentages de consommateurs, de 20 % jusqu’à 95 % |
| Carrés avec étiquettes | Position des stimuli testés dans l’espace choisi |
| Sous-titre | Rappelle la valeur de Preference threshold (SD) utilisée |
Avec le seuil par défaut 0, une zone élevée signifie qu’une grande proportion de consommateurs y a une préférence prédite supérieure à son propre niveau prédit moyen. La carte ne représente donc ni une moyenne brute de liking ni une probabilité au sens statistique.
Point de vigilance : la surface est modélisée sur une grille qui couvre le plan. Les zones éloignées des stimuli observés relèvent davantage de l’extrapolation et doivent être interprétées avec prudence.
Point de vigilance : une surface lisse ne garantit pas une forte robustesse. Le nombre de stimuli, le modèle choisi et la diversité des consommateurs déterminent la quantité d’information disponible.
8.6.2 Consumer Cluster Sizes (si Classification of consumers est activé)
Cette table donne, pour chaque cluster, le nombre de consommateurs et leur pourcentage dans l’échantillon. Elle permet de repérer immédiatement les segments dominants et les groupes très petits, qui doivent être interprétés avec davantage de prudence.
8.6.3 Consumer Cluster Membership (si Classification of consumers est activé)
Cette table indique le cluster attribué à chaque consommateur. Elle permet de relier les segments aux colonnes de liking d’origine ou de poursuivre leur caractérisation dans une analyse complémentaire.
8.6.4 Consumer Cluster Dendrogram (optionnel)
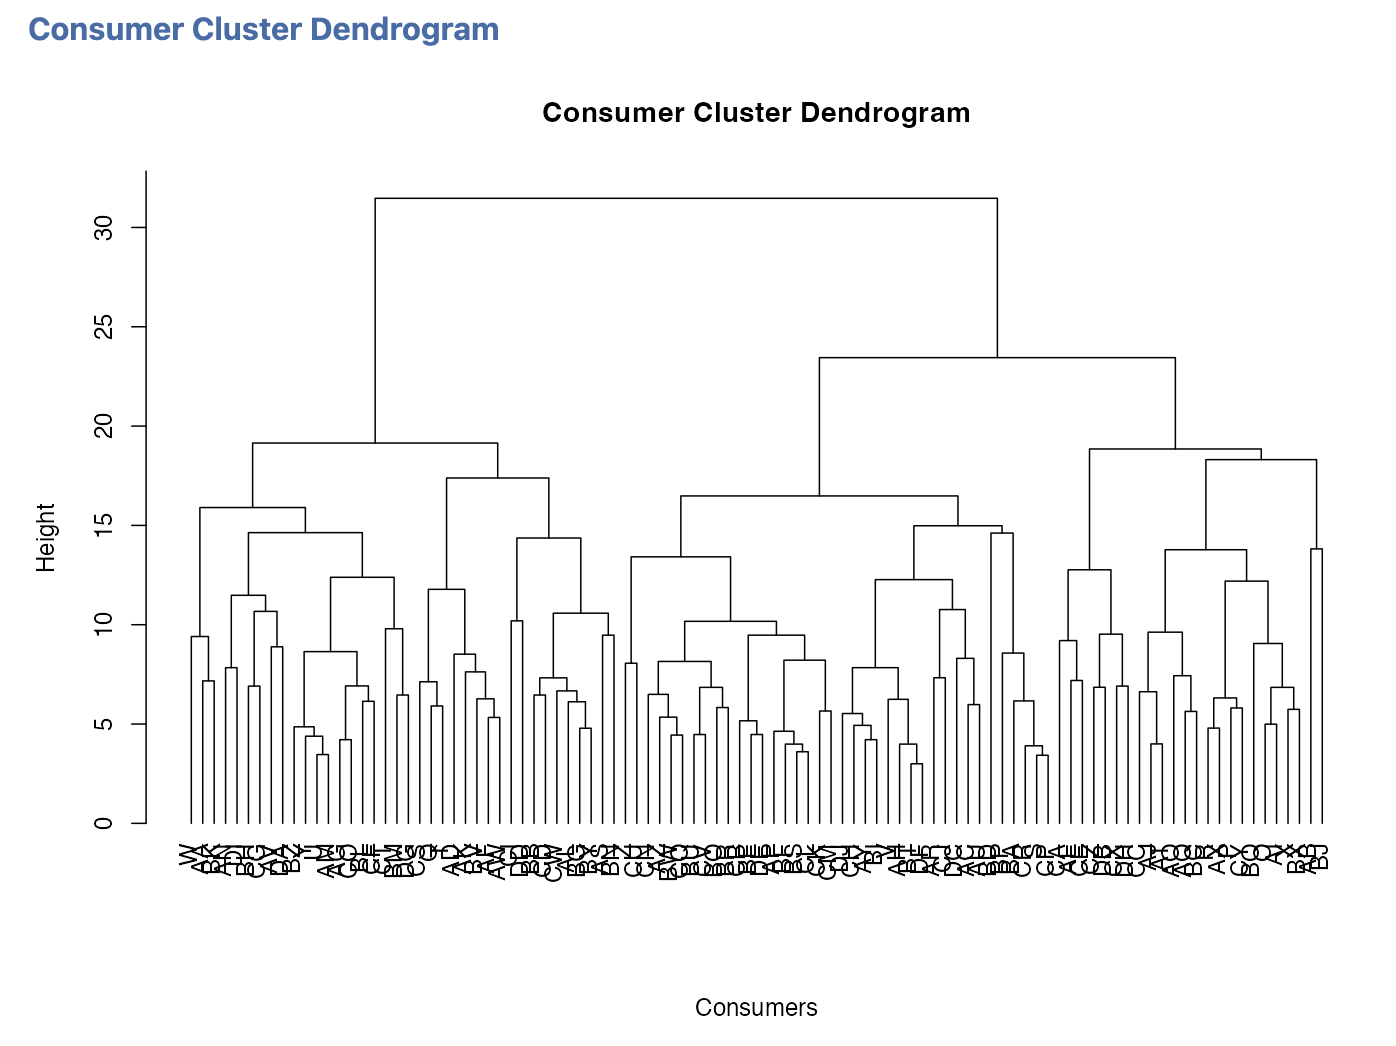
Le dendrogramme représente la classification hiérarchique de Ward calculée sur les profils de liking centrés. Deux consommateurs proches dans cette hiérarchie ont des structures de préférence semblables entre les produits, indépendamment en grande partie de leur niveau moyen de notation.
8.6.5 Preference Maps by Consumer Cluster (optionnel)
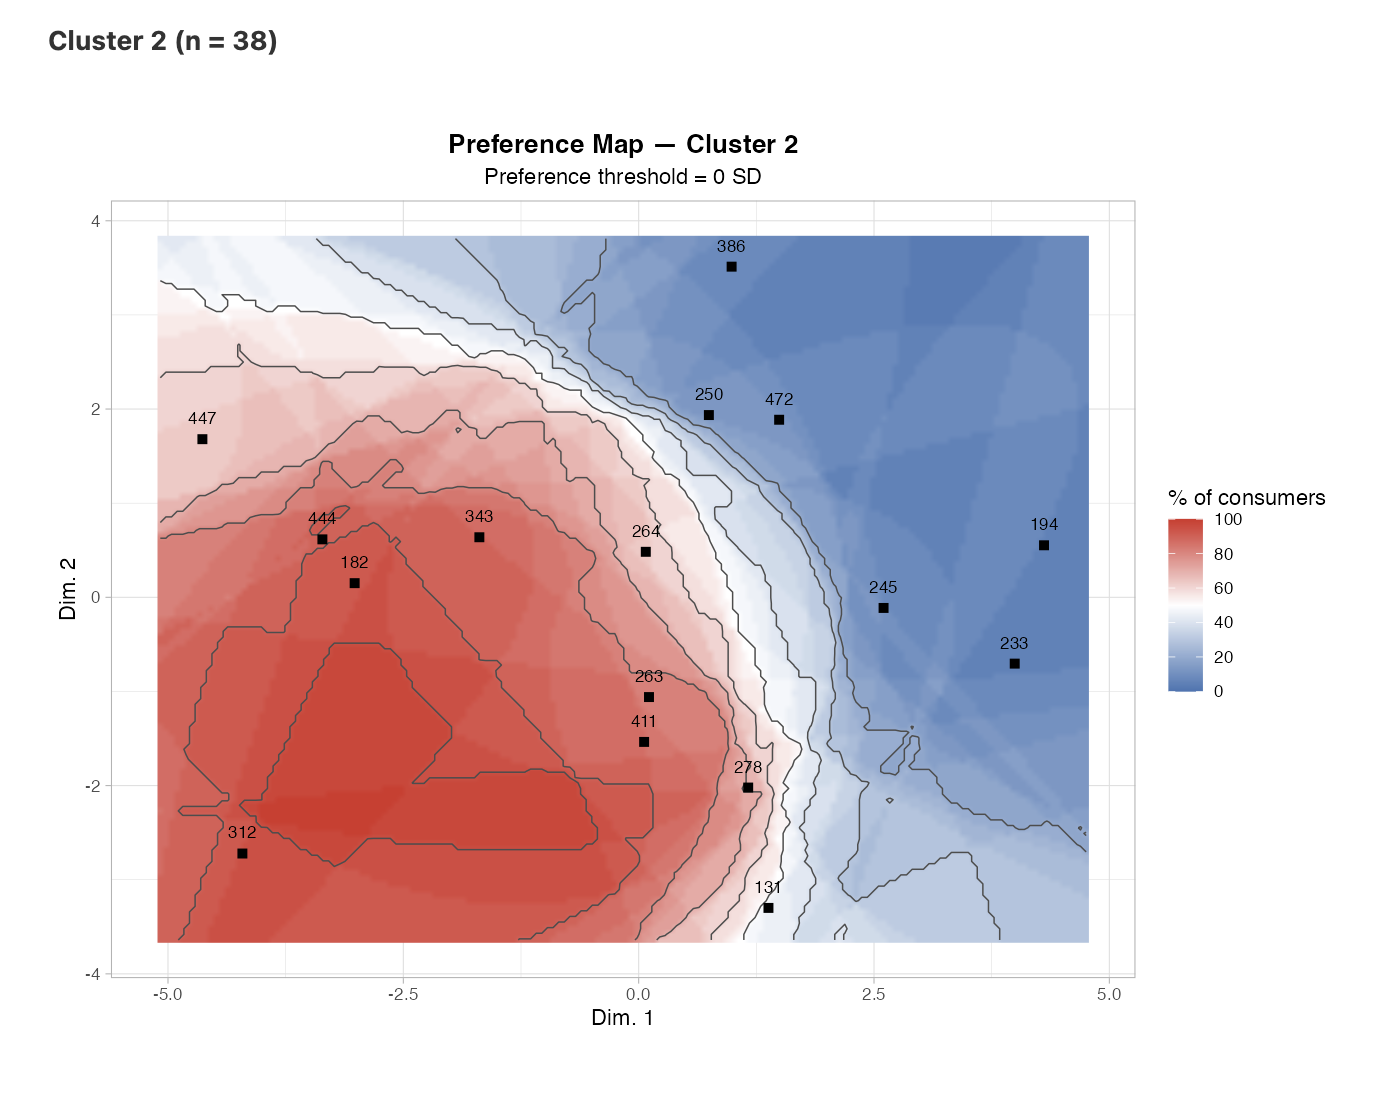
Une carte est recalculée pour chaque cluster avec le même espace produit, le même Regression model et le même Preference threshold (SD) que la carte globale. Les différences entre cartes peuvent donc être lues comme une hétérogénéité des structures de préférence entre segments, et non comme un changement de repère factoriel. Sur une carte propre à un cluster, le % of consumers est calculé au sein de ce cluster : 100 % signifie tous les consommateurs de ce segment, et non tous les consommateurs du panel complet.
8.7 Exemple : le jeu de données senso_hedo_cocktail
Le jeu de données senso_hedo_cocktail contient les évaluations sensorielles de 16 cocktails décrits par 13 attributs, ainsi que les notes de liking individuelles de 100 consommateurs. Il sert à illustrer la construction d’une cartographie des préférences : l’espace sensoriel est d’abord construit par ACP dans MEDA, puis les notes hédoniques y sont projetées via cette fonction. Les valeurs numériques et les graphiques commentés ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
8.7.1 Paramètres de l’exemple
Pour reproduire l’exemple principal et afficher également la segmentation des consommateurs, utilisez les valeurs suivantes.
| Option | Valeur |
|---|---|
| Stimuli Labels | variable identifiant les cocktails |
| X-axis | Dim. 1 (sauvegardée depuis l’ACP) |
| Y-axis | Dim. 2 (sauvegardée depuis l’ACP) |
| Liking Variables | toutes les colonnes hédoniques (O à DJ) |
| R code | coché |
| Regression model | Quadratic |
| Preference threshold (SD) | 0 |
| Classification of consumers | coché |
| Number of clusters | -1 |
| Cluster dendrogram | coché |
| Preference maps by cluster | coché |
| Color for low preference areas | Blue |
| Color for high preference areas | Red |
8.7.2 Étape 1 — Construire l’espace sensoriel dans MEDA (PCA)
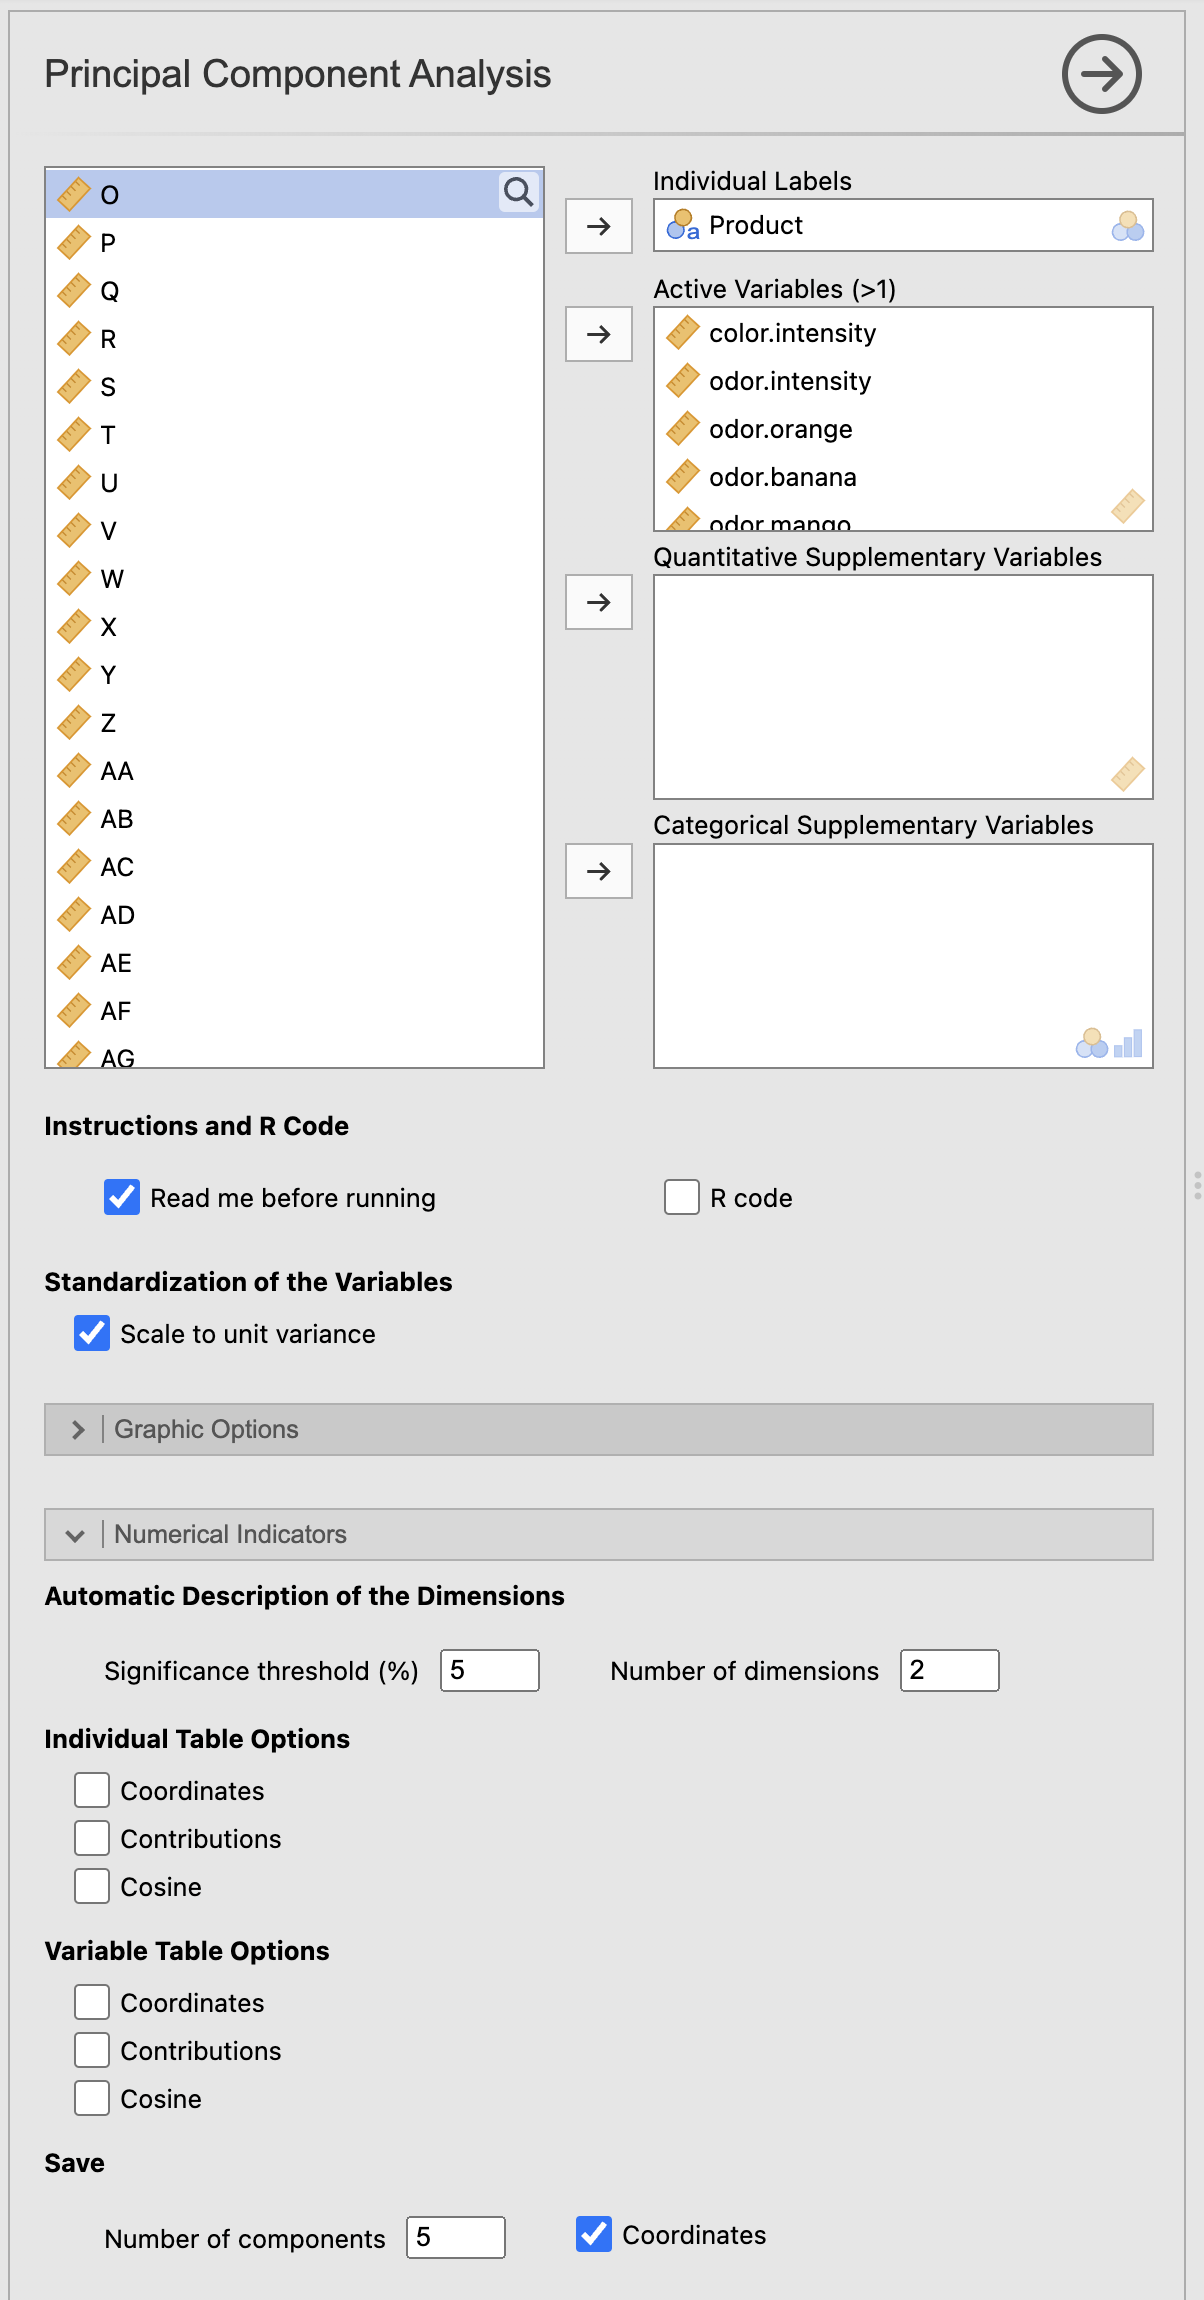
Dans le module MEDA, lancez une ACP sur les 13 attributs sensoriels avec les réglages suivants :
| Option | Valeur |
|---|---|
| Active Variables | les 13 attributs sensoriels |
| Scale to unit variance | Coché |
| Number of components (Save) | 2 |
| Coordinates (Save) | Coché |
Figure 8.1 présente la configuration de l’ACP utilisée pour construire l’espace sensoriel.
L’ACP produit un espace en deux dimensions : Dim. 1 explique 53.25 % de la variance et Dim. 2 en explique 24.13 %, soit 77.37 % cumulés. Le plan 1/2 résume donc bien les profils sensoriels des cocktails.
La description automatique des dimensions confirme l’interprétation des axes :
- Dim. 1 oppose acidity (corrélation 0.93), bitterness (0.88), odor.orange (0.75) et intensity (0.73) d’un côté, à odor.banana (-0.93), sweet (-0.93), thickness (-0.88) et pulp (-0.70) de l’autre. C’est une opposition nette entre des cocktails acides et intenses vs des cocktails sucrés, épais et bananés.
- Dim. 2 est davantage structurée par odor.lemon (0.77), odor.mango (0.69), persistence (0.66) et color.intensity (0.58), avec odor.orange (-0.61) en négatif.
Sur la carte des individus, les cocktails se distribuent largement dans le plan. 386 se situe en haut à droite (fort sur Dim. 2), 131 en bas au centre, 447 et 312 à gauche (sucrés, épais), 194, 233 et 245 à droite (acides, intenses). Une fois l’ACP lancée, les colonnes Dim. 1 et Dim. 2 apparaissent automatiquement dans la feuille de données jamovi.
8.7.3 Étape 2 — Construire la carte de préférence dans SEDA
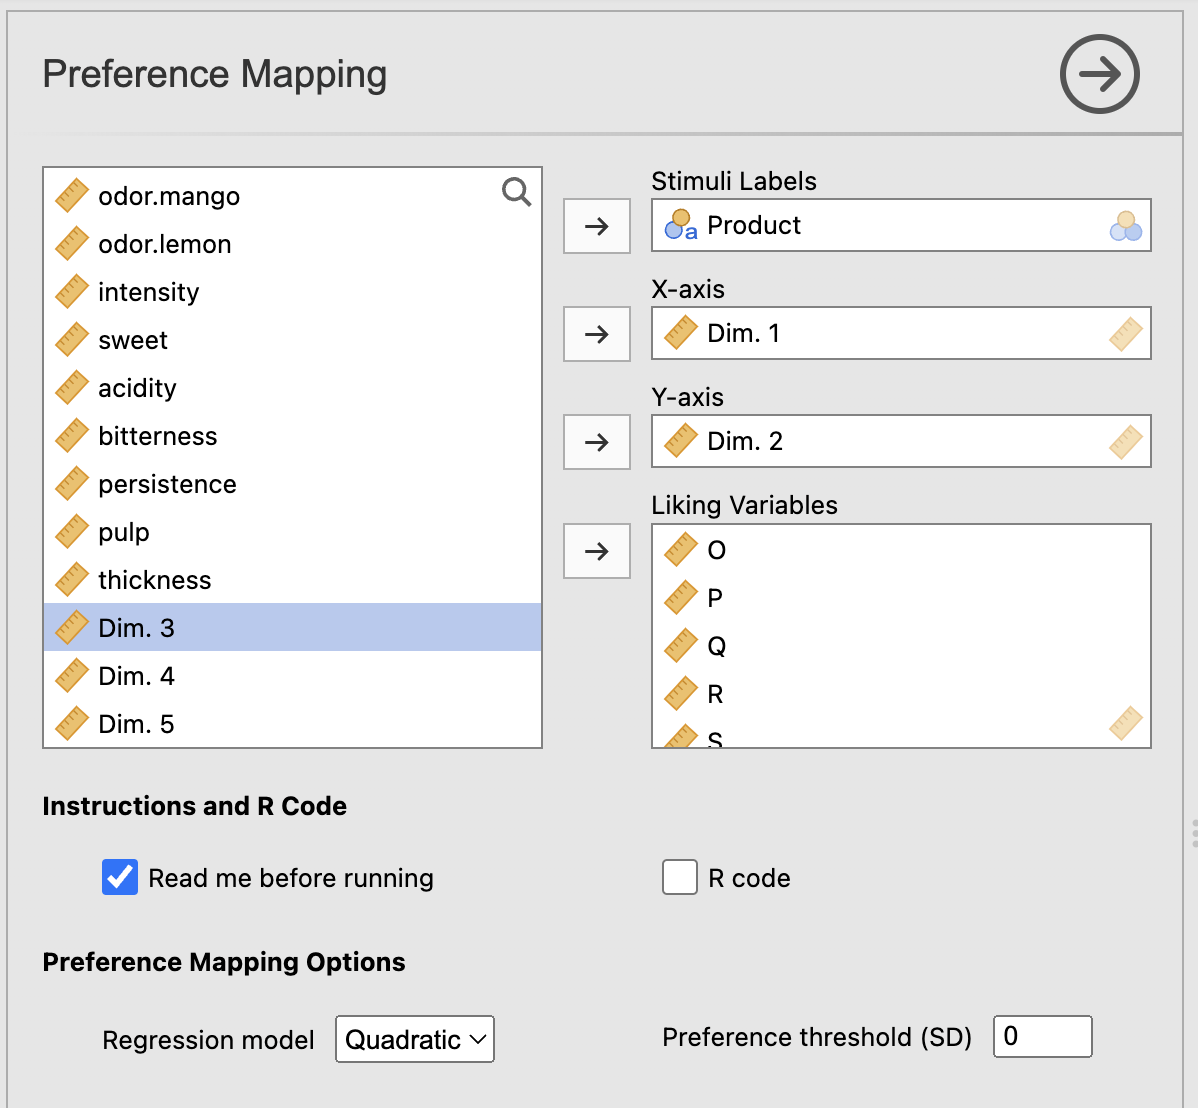
Revenez dans SEDA > Hedonic Data > Preference Mapping et utilisez les coordonnées sauvegardées comme X-axis et Y-axis. Sélectionnez les colonnes hédoniques dans Liking Variables, gardez Regression model = Quadratic et Preference threshold (SD) = 0.
Pour reproduire également la lecture par segments, activez Classification of consumers, laissez Number of clusters = -1, et gardez Cluster dendrogram et Preference maps by cluster cochés. La carte globale ne change pas lorsque la classification est activée ; celle-ci ajoute des résultats complémentaires sur l’hétérogénéité des consommateurs.
Figure 8.2 présente la configuration de la cartographie des préférences dans SEDA.
8.7.4 Analyse du graphique Overall Preference Map
Figure 8.3 montre la carte globale des préférences.
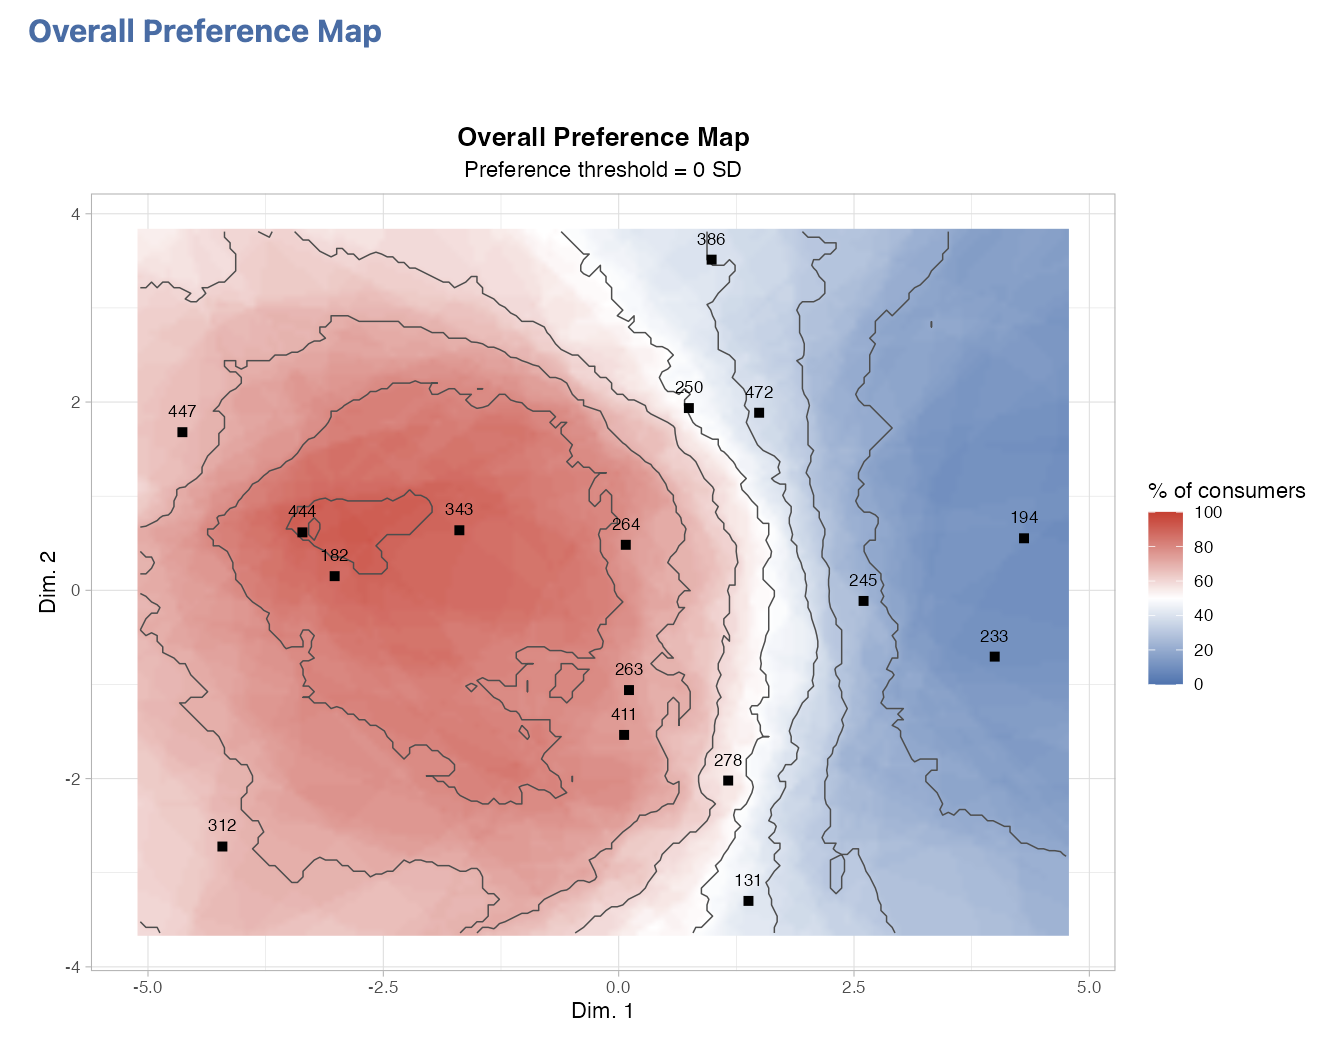
La carte résultante superpose la surface de préférence à la position des 16 cocktails dans l’espace sensoriel. La zone rouge foncée — correspondant à plus de 80–90 % de consommateurs favorables — se situe à gauche du plan, dans la région des coordonnées négatives sur Dim. 1, là où se trouvent les cocktails 182, 444, 343 et 447. Ces cocktails, caractérisés par des profils plus sucrés, épais et bananés, se situent dans une zone de forte préférence.
À l’inverse, la zone bleue — correspondant à moins de 20 % de consommateurs favorables — se situe à droite du plan, là où se trouvent les cocktails 194, 233 et 245, caractérisés par des profils acides et intenses.
Les cocktails 131 (en bas au centre) et 386 (en haut à droite) se situent dans des zones intermédiaires à faible préférence (bleu clair, 10–25 %).
8.7.5 Lecture de la classification des consommateurs
Avec Number of clusters = -1, la classification de Ward appliquée aux profils de liking centrés retient 2 clusters de consommateurs dans cet exemple :
- Cluster 1 : 62 consommateurs (62.0 %). Les produits présentant le liking relatif le plus élevé dans le profil centré du cluster sont 182, 447, 472.
- Cluster 2 : 38 consommateurs (38.0 %). Les produits présentant le liking relatif le plus élevé dans le profil centré du cluster sont 343, 312, 182.
Le produit 182 figure parmi les liking relatifs les plus élevés dans les deux clusters, tandis que 447/472 distinguent davantage le cluster 1 et 343/312 le cluster 2 parmi les cocktails observés. Cela donne une première lecture concrète de ce qui est partagé et de ce qui différencie les segments.
Ces descriptions courtes reposent sur le profil moyen de liking centré au sein de chaque cluster. Elles indiquent quels produits testés caractérisent le mieux les préférences relatives d’un segment ; elles ne donnent pas, à elles seules, une signification sensorielle au segment.
Utilisez Consumer Cluster Sizes pour apprécier le poids de chaque segment et Consumer Cluster Membership pour identifier les consommateurs qui le composent. Le Consumer Cluster Dendrogram montre la hiérarchie à l’origine de la partition.
Figure 8.4 montre la hiérarchie de la classification des consommateurs.
Les Preference Maps by Consumer Cluster doivent ensuite être comparées dans le même espace sensoriel. Comme chaque carte utilise exactement les mêmes coordonnées produit, le même modèle de régression et le même seuil que la carte globale, leurs différences traduisent une hétérogénéité des structures de préférence prédites et non un changement de repère. Les clusters très petits doivent néanmoins être interprétés avec prudence.
Figure 8.5 montre la carte des préférences du cluster 1.
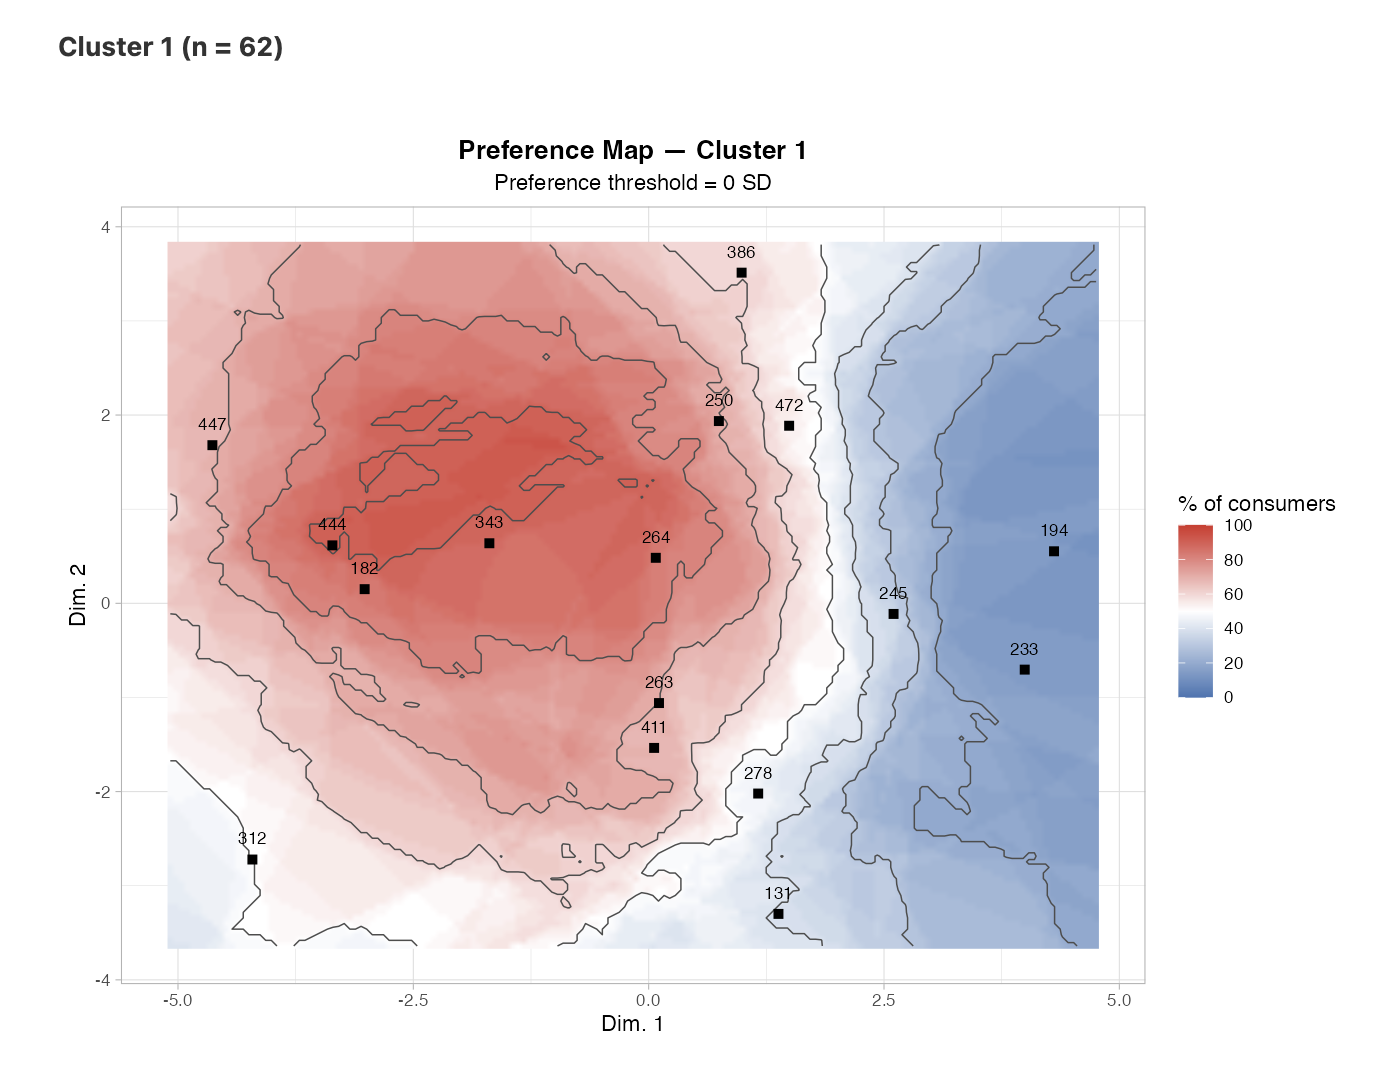
Figure 8.6 montre la carte des préférences du cluster 2.
8.7.6 Interprétation synthétique
L’espace sensoriel structuré par l’ACP, fondé sur l’opposition acide-intense vs sucré-épais, s’avère directement lisible sur la carte de préférences. La région de préférence la plus élevée se situe du côté sucré-épais, tandis que les profils acides et intenses sont moins appréciés. Aucun cocktail ne semble occuper exactement le centre de cette région de forte préférence, ce qui suggère davantage une direction d’amélioration de la formulation qu’un produit déjà optimal.
Ce qu’on retient de cet exemple : la cartographie des préférences relie directement l’espace sensoriel et les préférences hédoniques, ce qui permet d’identifier une région favorable de l’espace produit même lorsqu’aucun produit existant n’en occupe exactement le centre.
8.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code pour afficher le script correspondant à l’analyse. Le jeu de données ouvert dans jamovi est disponible sous le nom data.
Le code généré reconstruit les deux coordonnées et les colonnes de liking, ajuste une surface de réponse séparée pour chaque consommateur, standardise les prédictions sur la grille et applique Preference threshold (SD) avant de calculer le % of consumers. Il reproduit ainsi explicitement la logique de la carte plutôt que de traiter celle-ci comme une simple moyenne de liking.
Si Classification of consumers est activé, le script centre également les profils hédoniques, calcule les distances entre consommateurs, exécute la classification de Ward avec hclust(..., method = "ward.D2"), utilise cutree() pour former les groupes, puis recalcule une carte avec les consommateurs de chaque cluster. Le code généré permet donc de retrouver à la fois la carte globale et toute la segmentation dans le Rj Editor.
8.9 Conseils pratiques
- Vérifiez toujours que X-axis et Y-axis proviennent du même espace de représentation et correspondent aux mêmes stimuli que les notes hédoniques.
- Utilisez les notes individuelles dans Liking Variables, une colonne par consommateur.
- Commencez avec Preference threshold (SD) = 0 ; modifiez-le ensuite pour tester si les zones de préférence forte restent stables.
- Adaptez la complexité du Regression model au nombre de produits : les minima sont 4, 5, 6 et 7 produits pour Vector, Circular, Elliptical et Quadratic respectivement.
- Pour une cartographie externe, interprétez d’abord les axes sensoriels avant de traduire une zone favorable en direction de formulation.
- Si vous activez Classification of consumers, examinez d’abord la taille des groupes et soyez prudent avec les segments très petits.
- Comparez les cartes par cluster dans le même repère : leurs différences traduisent des préférences différentes, pas des espaces factoriels différents.
- Cochez R code lorsque vous souhaitez conserver une trace reproductible des réglages et des calculs.
8.10 En résumé
La cartographie des préférences relie un espace bidimensionnel de stimuli à des notes hédoniques individuelles. SEDA ajuste une surface de préférence pour chaque consommateur, standardise les prédictions et représente la proportion de consommateurs qui dépassent le Preference threshold (SD) dans chaque région du plan. La carte globale peut être complétée par une classification de Ward des profils hédoniques centrés et par des cartes propres à chaque segment. L’analyse permet ainsi de distinguer une zone de préférence partagée d’une préférence globale qui masque plusieurs groupes de consommateurs, tout en conservant le même espace produit pour toutes les comparaisons.