6 Données de Napping — Représentation consensuelle
6.1 Introduction
Cette analyse est conçue pour les données de Napping (projective mapping), dans lesquelles chaque sujet positionne un ensemble de stimuli dans un espace à deux dimensions selon leurs ressemblances et leurs différences perçues. Elle permet de construire une représentation consensuelle des stimuli à partir de plusieurs cartes individuelles, puis, si souhaité, de regrouper les stimuli en clusters. La fonction s’appuie sur une Analyse Factorielle Multiple (AFM) pour fusionner les différentes paires de coordonnées dans un même espace.
Pourquoi ne pas utiliser une alternative standard ?
Une ACP appliquée directement à toutes les colonnes de coordonnées tiendrait compte de leurs relations, mais ignorerait leur structure en groupes par sujet. Or, en Napping, les données sont naturellement organisées par paires X/Y fournies par chaque sujet. Ici, chaque paire est traitée comme un groupe dans l’AFM, ce qui permet de construire un compromis plus adapté entre les différentes cartes individuelles. Cette AFM utilise type = "c" dans FactoMineR : les coordonnées sont centrées mais non standardisées, afin de préserver la géométrie et l’échelle relative de chaque nappe plutôt que de forcer X et Y à avoir la même variance.
6.2 Comprendre ce qui se passe “sous le capot”
6.2.1 Les données sont lues par paires de coordonnées
La fonction attend dans Active (X,Y) Coordinate Pairs un ensemble de colonnes numériques organisées par paires consécutives : X puis Y pour un premier sujet, X puis Y pour un second, etc. Le même principe vaut pour Supplementary (X,Y) Coordinate Pairs. Si le nombre de colonnes est impair dans l’un des deux blocs, l’analyse est rejetée. Le bloc actif doit contenir au moins 4 colonnes, soit 2 paires. Une même coordonnée ne peut pas être utilisée à la fois comme active et supplémentaire.
6.2.2 Une AFM sur des groupes de taille 2, sans standardisation
Le cœur de l’analyse est une AFM. Chaque paire X/Y de Active (X,Y) Coordinate Pairs est traitée comme un groupe de deux variables quantitatives. L’AFM construit un espace commun qui résume l’information portée par l’ensemble des sujets en équilibrant la contribution des groupes. Avec type = "c", les coordonnées sont centrées mais non standardisées : l’analyse conserve ainsi l’échelle relative des deux coordonnées de chaque configuration individuelle.
6.2.3 Le rôle des coordonnées supplémentaires
Si vous fournissez des variables dans Supplementary (X,Y) Coordinate Pairs, elles sont projetées comme groupes supplémentaires dans l’AFM. Elles ne participent pas à la construction des axes, mais permettent de situer d’autres sujets dans le même espace.
6.2.4 Description automatique des dimensions
Une fois l’AFM calculée, la fonction produit une description automatique des dimensions filtrée par Significance threshold (%) et Number of dimensions. Cette sortie aide à comprendre quelles variables sont les plus liées aux premiers axes.
6.2.5 Sauvegarde des dimensions et clustering
Le champ Number of dimensions to save/use for clustering détermine combien de premières dimensions sont sauvegardées dans Coordinates et utilisées pour la classification. Si le nombre demandé dépasse le nombre de dimensions disponibles, SEDA utilise celles qui peuvent effectivement être calculées. Si vous activez Representation of the clusters ou demandez Cluster variable, la fonction lance une HCPC sur ces dimensions retenues. Par défaut, le clustering utilise les 5 premières dimensions, et Number of clusters = -1 laisse FactoMineR choisir automatiquement le nombre de clusters. Les pourcentages affichés sur la carte HCPC se rapportent à cet espace de classification retenu et peuvent donc différer de ceux de la carte AFM complète.
6.3 Structure des données attendues
Les données doivent contenir :
- une colonne facultative mais fortement recommandée pour Stimuli Labels ;
- au moins deux paires de colonnes numériques dans Active (X,Y) Coordinate Pairs ;
- éventuellement des paires numériques dans Supplementary (X,Y) Coordinate Pairs.
Chaque ligne correspond à un stimulus. Cela distingue cette analyse d’autres analyses où chaque ligne correspond à une réponse individuelle. SEDA exige au moins trois stimuli. Si Stimuli Labels n’est pas renseigné, la fonction utilise les numéros de ligne comme noms de stimuli.
Avant de lancer l’analyse dans jamovi, vérifiez dans l’onglet Données que :
- Stimuli Labels est catégorielle si vous l’utilisez, sans valeur manquante ou vide et avec un libellé unique par stimulus ;
- toutes les coordonnées actives et supplémentaires sont numériques, complètes et finies ;
- le nombre de colonnes dans chacun des deux blocs de coordonnées est pair ;
- aucune coordonnée n’est sélectionnée à la fois comme active et supplémentaire ;
- chaque paire X/Y présente de la variabilité sur au moins une de ses deux coordonnées.
6.4 Guide de l’interface
L’analyse apparaît dans SEDA > Free Perception > Analysis of Napping Data. L’interface comprend trois zones de dépôt de variables, une section Instructions and R Code, puis les menus Graphic Options, Numerical Indicators et Clustering.
6.4.1 Variables à renseigner
6.4.1.1 Stimuli Labels
Rôle : fournit les noms des stimuli dans les sorties. Impact sur le calcul : cette variable ne modifie pas l’AFM elle-même, mais détermine les étiquettes affichées dans les graphiques et les noms associés aux coordonnées sauvegardées. Conseil pratique : utilisez des libellés courts et uniques ; sinon, la lecture des cartes devient vite difficile.
6.4.1.2 Active (X,Y) Coordinate Pairs
Rôle : regroupe les coordonnées actives utilisées pour construire la représentation consensuelle. Impact sur le calcul : chaque paire X/Y devient un groupe dans l’AFM. Le nombre de colonnes doit être pair, et la fonction exige au moins 4 colonnes. Conseil pratique : respectez strictement l’ordre X, Y, X, Y… pour éviter une organisation incorrecte des groupes.
6.4.1.3 Supplementary (X,Y) Coordinate Pairs
Rôle : ajoute des paires de coordonnées projetées comme groupes supplémentaires. Impact sur le calcul : ces coordonnées n’influencent pas la construction des axes, mais sont projetées dans l’espace AFM. Conseil pratique : utilisez ce bloc pour projeter un second panel sans modifier le compromis principal.
6.4.2 Instructions and R Code
6.4.2.1 Read me before running
Rôle : affiche une aide intégrée dans les résultats. Impact sur le calcul : aucun. Conseil pratique : laissez-la cochée lors des premières utilisations. Elle est activée par défaut.
6.4.2.2 R code
Rôle : affiche le script R correspondant à l’analyse dans une sortie R Code. Impact sur le calcul : aucun. Conseil pratique : activez cette option pour reproduire l’analyse dans le Rj Editor. Elle est désactivée par défaut.
6.4.3 Graphic Options
6.4.3.1 X-axis
Rôle : choisit la dimension affichée en abscisse. Impact sur le calcul : ne modifie pas l’AFM, mais change le plan factoriel affiché dans les graphiques. Conseil pratique : commencez avec 1 (valeur par défaut).
6.4.3.2 Y-axis
Rôle : choisit la dimension affichée en ordonnée. Impact sur le calcul : ne modifie pas l’AFM, mais change le plan factoriel affiché dans les graphiques. Conseil pratique : commencez avec 2 (valeur par défaut).
6.4.4 Numerical Indicators
6.4.4.1 Significance threshold (%)
Rôle : fixe le seuil de significativité de la description automatique des dimensions. Impact sur le calcul : plus le seuil est strict, plus la description automatique est sélective. Conseil pratique : la valeur par défaut 5 % constitue un bon point de départ.
6.4.4.2 Number of dimensions
Rôle : détermine le nombre d’axes décrits automatiquement. Impact sur le calcul : pilote la sortie de description des dimensions et contribue aussi à déterminer le nombre de dimensions de l’AFM calculées en interne. Conseil pratique : laissez 2 pour une première lecture.
6.4.4.3 Number of dimensions to save/use for clustering
Rôle : définit le nombre de premières dimensions à sauvegarder et à utiliser pour la classification. Impact sur le calcul : détermine les colonnes enregistrées dans Coordinates et les dimensions transmises à HCPC ; si moins de dimensions sont disponibles, SEDA utilise le maximum calculable. Conseil pratique : la valeur par défaut 5 constitue un bon point de départ.
6.4.4.4 Coordinates
Rôle : permet d’enregistrer les coordonnées factorielles des stimuli dans la feuille de données jamovi. Impact sur le calcul : n’ajoute pas de nouveau calcul, mais sauvegarde les résultats de l’AFM. Conseil pratique : activez cette sortie si vous souhaitez réutiliser les dimensions dans d’autres analyses jamovi.
6.4.5 Clustering
6.4.5.1 Representation of the clusters
Rôle : active l’affichage du graphique de clustering. Impact sur le calcul : lorsque cette option est cochée, la fonction calcule la classification HCPC si nécessaire et affiche la carte des stimuli selon les clusters. Conseil pratique : laissez-la décochée pour une première lecture, puis activez-la pour compléter la carte consensuelle par une lecture en groupes.
6.4.5.2 Number of clusters
Rôle : fixe le nombre de clusters à extraire. Impact sur le calcul : avec -1, le nombre de clusters est déterminé automatiquement ; sinon, vous pouvez imposer un entier compris entre 2 et le nombre de stimuli moins 1. Conseil pratique : commencez avec -1, puis fixez un nombre seulement si vous avez une justification analytique claire.
6.4.5.3 Cluster variable
Rôle : enregistre l’appartenance de chaque stimulus à un cluster comme nouvelle variable dans jamovi. Impact sur le calcul : n’ajoute pas de nouveau calcul, mais sauvegarde les résultats de la classification. Conseil pratique : utile si vous voulez ensuite croiser les clusters avec d’autres variables dans jamovi.
6.5 Procédure pas à pas
- Ouvrez votre jeu de données dans jamovi.
- Dans l’onglet Données, vérifiez que les colonnes de coordonnées sont numériques et organisées par paires X/Y.
- Si vous avez une colonne d’identifiants de stimuli, vérifiez qu’elle est catégorielle.
- Ouvrez SEDA > Free Perception > Analysis of Napping Data.
- Placez la colonne des noms de stimuli dans Stimuli Labels.
- Placez toutes les paires actives dans Active (X,Y) Coordinate Pairs.
- Placez, si besoin, les paires supplémentaires dans Supplementary (X,Y) Coordinate Pairs.
- Vérifiez que les coordonnées sont complètes et que chaque bloc contient un nombre pair de colonnes.
- Laissez X-axis = 1 et Y-axis = 2.
- Laissez Significance threshold (%) = 5, Number of dimensions = 2 et Number of dimensions to save/use for clustering = 5.
- Commencez par Eigenvalue Decomposition, puis lisez Representation of the Stimuli et Representation of the Subjects.
- Consultez ensuite Automatic Description of the Dimensions.
- Activez Representation of the clusters si vous souhaitez visualiser Representation of the Stimuli According to Clusters.
- Cochez R code pour obtenir le script reproductible et enregistrez éventuellement Coordinates et Cluster variable.
6.6 Interprétation des résultats
6.6.1 Representation of the Stimuli
C’est le résultat important de la fonction. Elle représente les stimuli dans l’espace factoriel de consensus construit par l’AFM. Deux stimuli proches ont été positionnés de manière similaire par l’ensemble des sujets ; deux stimuli éloignés sont perçus comme plus différents. Le pourcentage affiché sur chaque axe indique la part de variance expliquée par la dimension correspondante.
| Élément | Signification |
|---|---|
| Deux stimuli proches | Perceptions globales proches |
| Deux stimuli éloignés | Perceptions globales différentes |
| Groupe compact de stimuli | Famille de stimuli perçus comme voisins |
Point de vigilance : la carte des stimuli montre une structure perceptive, mais elle ne suffit pas toujours à nommer les axes. L’ajout d’information supplémentaire (verbalisation) peut grandement aider à l’interprétation.
6.6.2 Representation of the Subjects
Cette carte représente les groupes de coordonnées X/Y — donc les configurations individuelles des sujets — dans l’espace factoriel. Elle montre comment chaque nappe est reliée aux dimensions du compromis.
| Élément | Signification |
|---|---|
| Groupes occupant des positions proches | Configurations liées de façon similaire aux dimensions communes |
| Groupe éloigné de l’origine sur un axe | Configuration fortement liée à cette dimension |
| Groupe proche de l’origine | Configuration peu liée aux dimensions affichées |
6.6.3 Eigenvalue Decomposition — tableau des valeurs propres
| Élément | Signification |
|---|---|
| Dim. | Numéro de la dimension |
| Eigenvalue | Importance de la dimension |
| % of variance | Part de la variabilité expliquée |
| Cumulative % | Part cumulée expliquée |
Si les deux premières dimensions expliquent une part importante de la variance, le plan 1/2 donne une bonne synthèse ; sinon, il peut être utile d’explorer d’autres plans factoriels.
6.6.4 Automatic Description of the Dimensions
Cette sortie décrit automatiquement les dimensions retenues selon Significance threshold (%) et Number of dimensions. Elle aide à repérer quelles variables sont les plus liées aux axes et devient particulièrement utile quand des Supplementary (X,Y) Coordinate Pairs ont été ajoutées.
6.6.5 Representation of the Stimuli According to Clusters (disponible si “Representation of the clusters” est activé)
Ce graphique montre les stimuli dans l’espace factoriel, regroupés selon les clusters issus de la classification HCPC. La classification utilise les premières dimensions définies par Number of dimensions to save/use for clustering, et pas seulement les deux axes affichés. Les pourcentages de la carte HCPC sont donc calculés relativement à cet espace retenu.
| Élément | Signification |
|---|---|
| Stimuli dans un même cluster | Profils de positionnement proches |
| Clusters bien séparés | Familles de stimuli bien différenciées |
6.6.6 Coordinates (sortie de données)
Cette sortie enregistre les coordonnées factorielles des stimuli sur les premières dimensions retenues par Number of dimensions to save/use for clustering. Chaque colonne correspond à une dimension (Dim. 1, Dim. 2, etc.).
6.6.7 Cluster variable (sortie de données)
Cette sortie enregistre l’appartenance de chaque stimulus à un cluster, sous forme de variable nominale. Elle est utile pour des analyses ultérieures dans jamovi.
6.7 Exemple : le jeu de données perfumes_napping
Le jeu de données perfumes_napping décrit 12 parfums positionnés sur une nappe (de dimension 60 par 40) par 60 sujets, soit 120 colonnes de coordonnées (une paire X/Y par sujet). Il sert à illustrer les sorties de la fonction. Les valeurs numériques et les graphiques commentés ci-dessous proviennent directement des résultats de l’analyse. Pour charger ce jeu de données, ouvrez jamovi, cliquez sur l’icône en haut à gauche (trois traits superposés), puis sur Open → Data Library → SEDA.
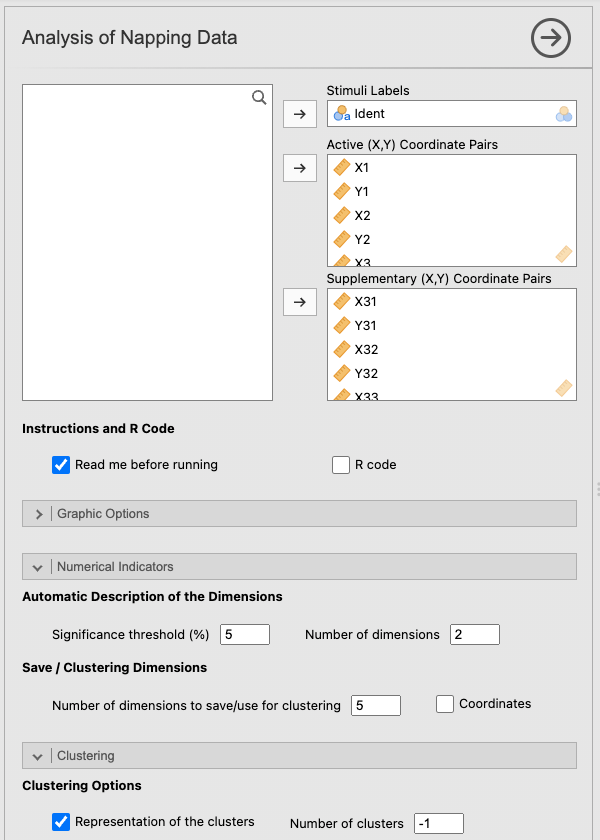
6.7.1 Paramètres de l’exemple
Pour reproduire cet exemple, voici les valeurs à utiliser.
| Option | Valeur |
|---|---|
| Stimuli Labels | variable Ident |
| Active (X,Y) Coordinate Pairs | les 60 premières colonnes de coordonnées (30 paires) |
| Supplementary (X,Y) Coordinate Pairs | les 60 colonnes de coordonnées suivantes (30 paires) |
| X-axis / Y-axis | 1 / 2 |
| Significance threshold (%) | 5 |
| Number of dimensions | 2 |
| Number of dimensions to save/use for clustering | 5 |
| Representation of the clusters | coché |
| Number of clusters | -1 |
| R code | coché |
Figure 6.1 présente la configuration utilisée pour l’exemple Napping.
6.7.2 Analyse du graphique Representation of the Stimuli
Figure 6.2 montre la représentation des stimuli dans l’espace factoriel commun.
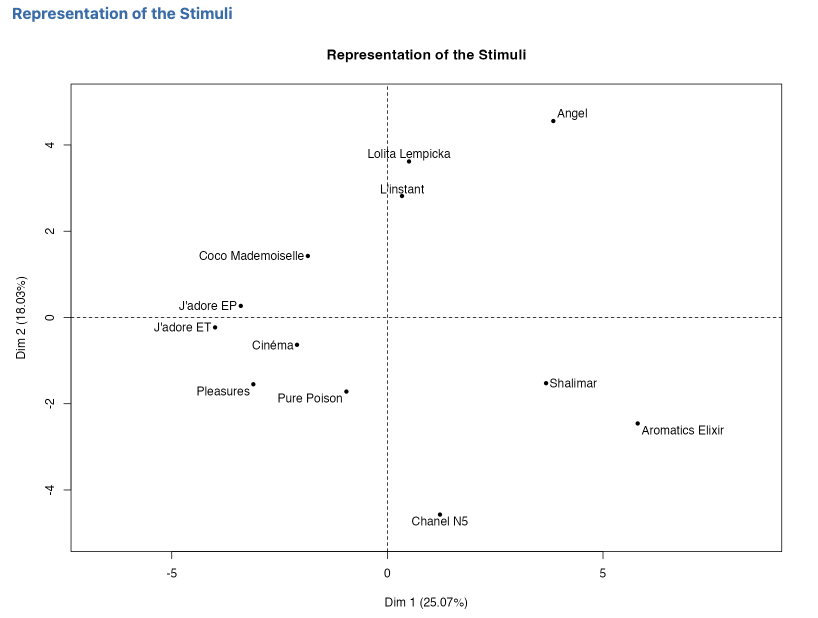
La carte fait apparaître une structure perceptive assez nette sur le plan Dim. 1 (25.07 %) / Dim. 2 (18.03 %). Sur l’axe horizontal, Aromatics Elixir et Shalimar se situent clairement à droite (coordonnées positives sur Dim. 1), tandis que J’adore EP, J’adore ET, Coco Mademoiselle, Cinéma, Pleasures et Pure Poison se trouvent à gauche. Chanel N5 se distingue de ce groupe de droite par une position basse sur la seconde dimension (valeur fortement négative sur Dim. 2), ce qui l’isole légèrement du couple Shalimar / Aromatics Elixir. Sur l’axe vertical, Angel, Lolita Lempicka et L’instant se situent nettement au-dessus du centre, constituant un groupe perceptif cohérent en haut du plan.
6.7.3 Analyse du graphique Representation of the Subjects
Figure 6.3 montre la représentation des configurations individuelles des sujets.
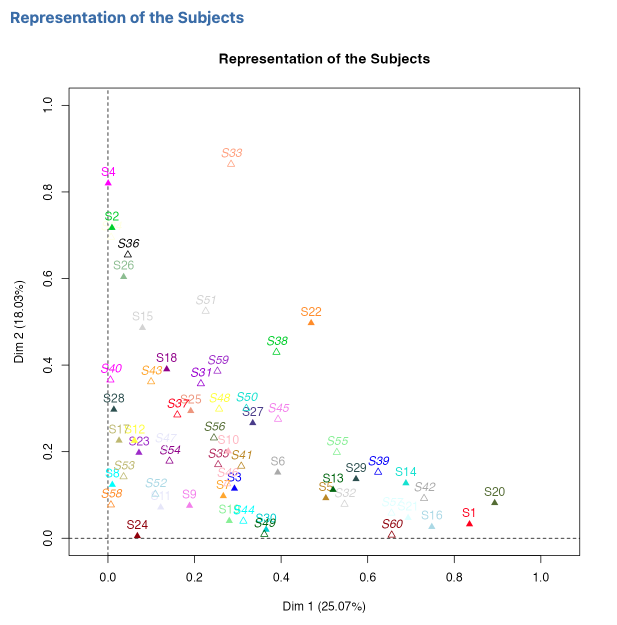
La carte des sujets représente les 60 groupes de coordonnées, S1 à S60. Les groupes situés loin de l’origine sur Dim. 1, comme S1 ou S20, sont fortement liés à la première dimension commune. Des groupes comme S4 ou S30, situés plus haut sur Dim. 2, sont davantage liés à la seconde. Les nombreux groupes proches de l’origine sont moins fortement associés aux deux dimensions affichées. Cette carte renseigne donc sur la relation entre les configurations individuelles et le compromis ; elle ne constitue pas, à elle seule, un indice numérique de consensus.
6.7.4 Analyse du tableau Eigenvalue Decomposition
Les deux premières dimensions expliquent 43.09 % de la variance totale (Dim. 1 : 25.07 %, Dim. 2 : 18.03 %). Le plan 1/2 fournit donc une première synthèse utile, mais plus de la moitié de la variabilité se trouve au-delà de ce plan. Les dimensions suivantes restent non négligeables (Dim. 3 : 12.31 %, Dim. 4 : 9.58 %, Dim. 5 : 7.96 %), ce qui justifie d’examiner d’autres plans si l’objectif l’exige.
6.7.5 Analyse du tableau Automatic Description of the Dimensions
La sortie Automatic Description of the Dimensions identifie les coordonnées X/Y les plus corrélées à chaque axe. Pour Dim. 1, les corrélations positives les plus fortes sont X20 (r = 0.93), X1 (r = 0.92) et Y21 (r = 0.90). À l’opposé, Y48 (r = -0.91) et X42 (r = -0.85) présentent les corrélations négatives les plus fortes. Ces résultats indiquent quelles directions des configurations individuelles sont les plus alignées, ou opposées, à la première dimension du compromis. Ils n’attribuent pas à eux seuls une signification sensorielle à l’axe.
6.7.6 Analyse du graphique Representation of the Stimuli According to Clusters
Figure 6.4 montre la représentation des stimuli selon les clusters.
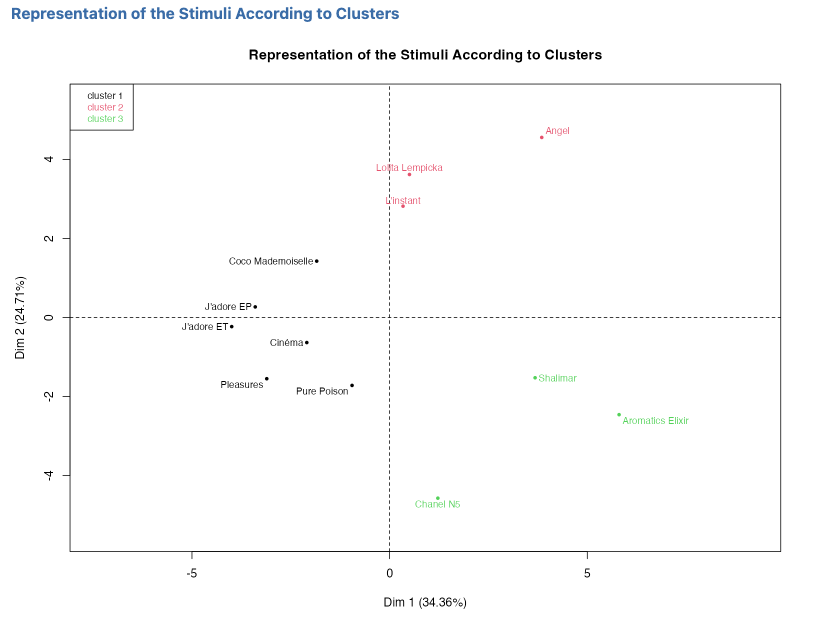
Avec Number of dimensions to save/use for clustering = 5, les dimensions AFM retenues cumulent 72.95 % de l’inertie totale. La carte HCPC exprime donc Dim. 1 et Dim. 2 relativement à cet espace à cinq dimensions : environ 34.37 % et 24.72 %, au lieu de 25.07 % et 18.03 % sur la carte AFM complète.
Avec Number of clusters = -1, la classification automatique retient trois clusters :
- Cluster 1 (noir) : Coco Mademoiselle, J’adore EP, J’adore ET, Cinéma, Pleasures et Pure Poison ;
- Cluster 2 (rouge) : Angel, Lolita Lempicka et L’instant ;
- Cluster 3 (vert) : Shalimar, Aromatics Elixir et Chanel N5.
Sur le plan 1/2, le premier groupe se situe principalement à gauche, le deuxième en haut et le troisième à droite et en bas. La classification est toutefois calculée sur les cinq premières dimensions retenues, et non uniquement sur ce plan. Sans information sensorielle externe ou verbalisation, il faut éviter d’attribuer automatiquement des qualités telles que « floral », « léger » ou « intense » à ces clusters.
6.7.7 Interprétation synthétique
Cet exemple montre bien l’intérêt de la fonction. On n’obtient pas seulement une carte moyenne des parfums : on construit un espace consensuel, on voit comment les configurations individuelles sont reliées à ses dimensions et quels groupes de parfums émergent de la classification. Les trois clusters sont nets dans cet exemple, mais leur interprétation sensorielle demanderait une information supplémentaire.
Ce qu’on retient de cet exemple : l’analyse Napping transforme un ensemble de cartes individuelles en une représentation consensuelle, puis permet d’examiner les relations entre configurations individuelles et dimensions communes ainsi que les groupes de stimuli.
6.8 De jamovi au Rj Editor
Une fois le Rj Editor configuré avec System R comme indiqué au chapitre 1, cochez R code pour afficher le script correspondant à l’analyse. Le jeu de données ouvert dans jamovi est disponible sous le nom data.
Pour le Napping, le script charge FactoMineR, construit une paire X/Y par sujet et exécute MFA() avec type = "c". Les paires supplémentaires sont indiquées avec num.group.sup. Le script reproduit ensuite les valeurs propres, les cartes des stimuli et des sujets avec plot.MFA(), puis la description automatique avec dimdesc().
Si une classification est demandée, le code conserve exactement les premières dimensions définies par Number of dimensions to save/use for clustering, exécute HCPC() sur cet espace retenu et affiche la carte avec plot.HCPC(). Le code généré dans cet exemple utilise 30 sujets actifs, 30 sujets supplémentaires et 5 dimensions pour la classification.
6.9 Conseils pratiques
- Vérifiez toujours que les colonnes de Active (X,Y) Coordinate Pairs sont complètes et fournies par paires X/Y.
- Utilisez Stimuli Labels presque systématiquement et vérifiez que les libellés sont uniques.
- Commencez avec X-axis = 1 et Y-axis = 2 ; si les deux premières dimensions résument peu de variance, explorez d’autres plans factoriels.
- Gardez Number of dimensions to save/use for clustering = 5 pour un premier essai, surtout si vous envisagez le clustering.
- Laissez Number of clusters = -1 au départ pour laisser la fonction choisir automatiquement.
- Lisez Representation of the Subjects comme la relation des configurations individuelles aux dimensions communes, et non comme un indice direct de consensus.
- N’attribuez pas de signification sensorielle aux axes ou aux clusters sans verbalisation ou information externe permettant de les caractériser.
- Activez Coordinates et Cluster variable si vous souhaitez réutiliser les résultats dans d’autres analyses jamovi.
6.10 En résumé
Cette analyse construit une carte consensuelle des stimuli à partir de données de Napping, en combinant les cartes individuelles par une AFM centrée mais non standardisée qui équilibre la contribution des groupes. Elle représente la structure des stimuli et la relation des configurations individuelles aux dimensions communes, et peut être complétée par une classification HCPC des stimuli sur les dimensions retenues. Son intérêt principal est de transformer un ensemble de cartes individuelles en une représentation commune des proximités perceptives, sans nécessiter de liste d’attributs prédéfinie.